Erros de entrada
Um único contador de erros responde só à pergunta «há um problema na entrada». Para uma cabeça de rede isso não basta: a causa decide a quem ligar. Pacotes perdidos são a rede, conexão recusada é o parceiro, tempo limite de handshake é o codificador dele ou o firewall entre vocês.
Por isso os erros de entrada são contados por causa, e cada causa é uma linha própria no gráfico e uma série própria nas métricas.
Duas famílias de causas
- Defeitos de mídia de um stream vivo — os dados chegam, mas danificados:
lost_packets,broken_payload,desync,ts_pat. - Falhas da fonte — não há dados, e a causa da morte é nomeada:
connection_closed,connection_refused,timeout,http_request_error,not_found,denied,decode_error,protocol_error,io_error,other.
A diferença é prática. A primeira família significa que o sinal está correndo e precisa ser consertado no nível de transporte — o próximo lugar a olhar são os contadores TR 101 290. A segunda significa que não há sinal algum, e o que precisa ser consertado é a conexão.
Como isto é contado:
- a classificação vem da categoria tipada do erro, e não do texto do log — reformular uma mensagem não quebra o contador;
- uma falha ao abrir uma fonte também entra no detalhe, não só a falha de uma conexão já em funcionamento;
- cada falha entra também no contador agregado
errors_total, de modo que as somas conferem; - as falhas repetidas nas tentativas são contadas a cada vez: a frequência de eventos é exatamente o sinal de «a fonte ainda está morta»;
- as paradas normais — reconfiguração, fim do stream, desalojo por uma entrada de maior prioridade — não contam como erros.
O gráfico no cartão do stream
O painel Erros e recuperações da fonte na aba Fontes desenha os erros por minuto como linhas separadas por causa. Causas sem eventos não ocupam lugar na legenda — o gráfico mostra exatamente o que está acontecendo.
Os minutos em que o ritmo de quadros de entrada foi zero são destacados como outage. Isso responde a uma pergunta que um único contador de erros nunca fecha: se aqueles erros eram com o sinal vivo, ou se naquele momento não havia sinal algum.
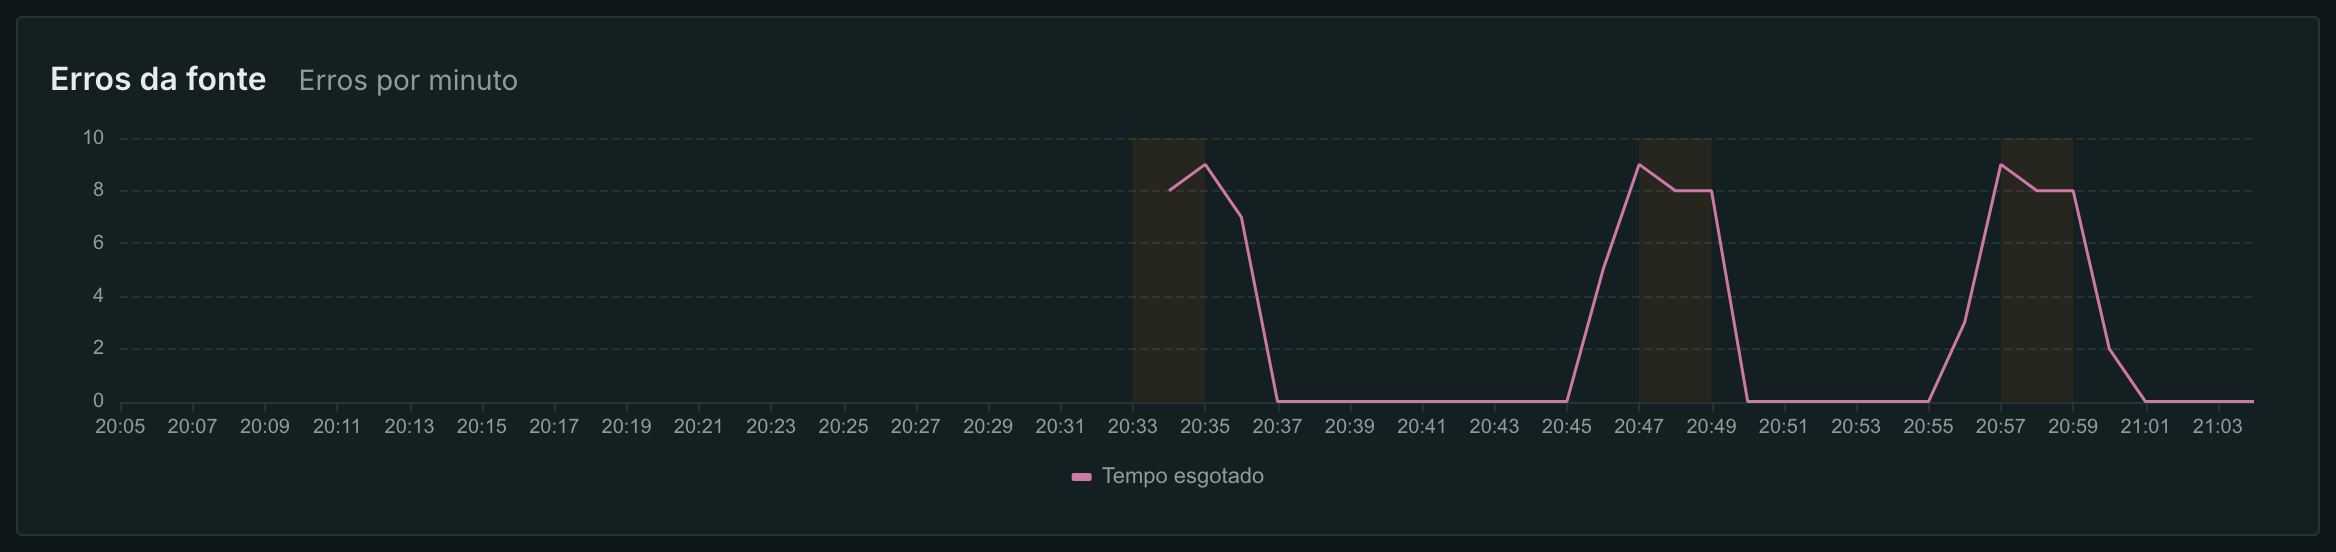
Uma fonte HLS ou HTTP MPEG-TS inacessível dá http_request_error em cada tentativa, e um handshake SRT que falha por tempo limite dá timeout:
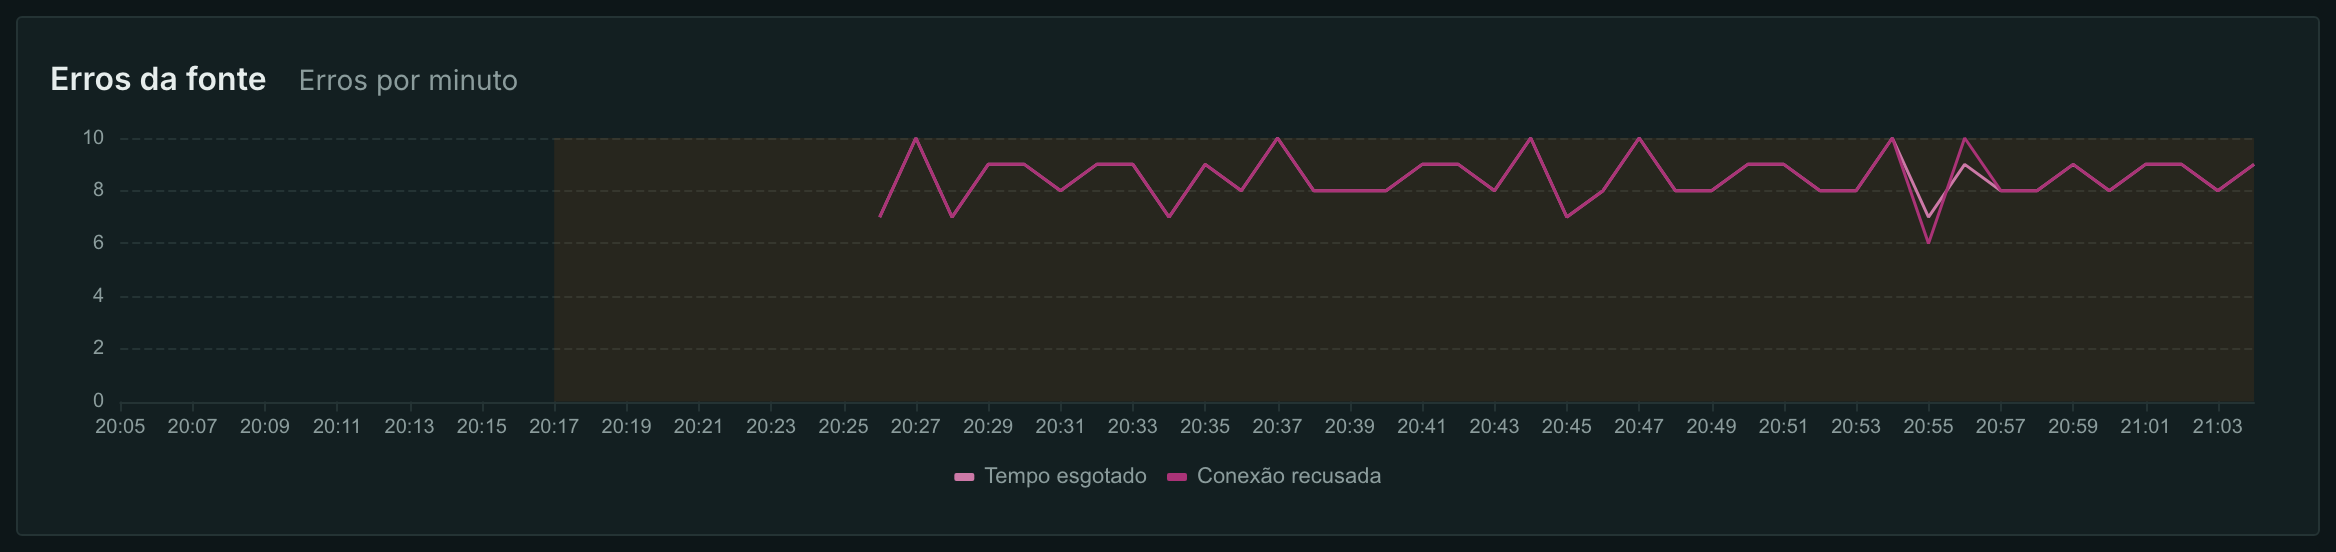
Sem a opção de contadores estendidos o painel mostra uma única linha agregada; as linhas detalhadas aparecem junto com a opção.
Perdas recuperadas
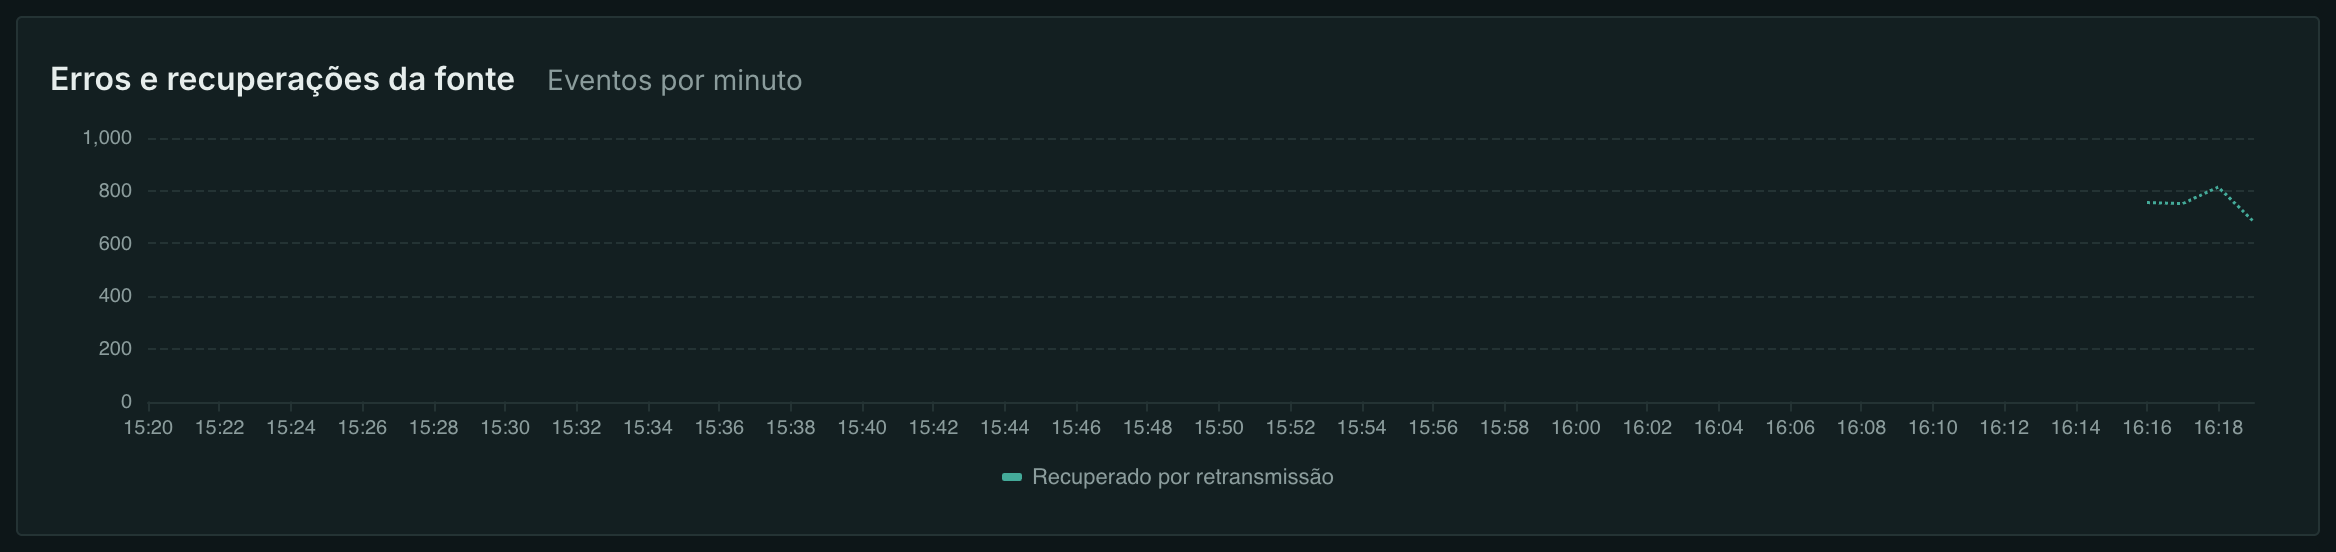
SRT e RIST recuperam parte das perdas de rede por retransmissão. As retransmissões aceitas que preenchem lacunas contam como recuperações. Uma linha pontilhada separada, Recuperado por retransmissão, mostra o número de pacotes recuperados por minuto.
A linha de recuperações mostra as perdas reparadas pelo transporte, ausentes do contador de perdas não recuperadas. O aumento das recuperações sem erros pode revelar a deterioração do enlace antes que haja perda de conteúdo.
- Contam apenas as retransmissões aceitas no buffer que preencheram uma lacuna. Retransmissões duplicadas, atrasadas ou rejeitadas não contam.
- As recuperações não fazem parte de
errors_totale não afetam a comutação de entradas: são avisos, e o agregado delas éwarnings_total. - A mesma linha existe para uma entrada SRT que puxa um stream e para uma porta de publicação SRT para a qual um stream é enviado.
A série de métricas
No servidor Prometheus incorporado o detalhe viaja como uma série com o rótulo de causa — errors_detail_total{name, cause}; quando há mais de uma estação, as séries levam também node. Causas sem eventos não criam séries.
# stream errors over 5 minutes broken down by cause
sum by (cause) (increase(errors_detail_total{name="tv1"}[5m]))

# every input currently seeing connection failures
sum by (name) (rate(errors_detail_total{cause="connection_closed"}[5m])) > 0
Os pacotes recuperados pelo transporte têm um contador cumulativo específico, warnings_recovered_packets_total{name}. Ele requer a opção de contadores ampliados; instalações com várias estações incluem também o rótulo node. O valor zero também é exportado:
# quanto a rede perdeu e o transporte recuperou, por entrada
sum by (name) (increase(warnings_recovered_packets_total[5m]))
Como ler
| O que se vê | O que significa |
|---|---|
lost_packets com bitrate vivo |
quem perde é a rede entre a fonte e a estação; use os contadores de transporte para achar o PID afetado |
timeout em rajadas, faixas de outage |
a fonte não responde; cada rajada é mais uma tentativa |
http_request_error como pente constante |
a fonte HTTP está inacessível: endereço, DNS, firewall ou uma origem morta |
connection_closed com o stream vivo |
o parceiro mesmo derruba a conexão; olhe o lado dele |
denied, not_found |
acesso ou caminho: a chave, o streamid, o nome do recurso |
desync, broken_payload |
os dados chegam quebrados — o transporte ou o codificador do outro lado |
| Recuperado por retransmissão cresce, sem erros | o enlace perde pacotes, mas a latência de recepção basta; acompanhe a tendência |
aparecem lost_packets ao lado de recuperações crescentes |
a retransmissão já não chega a tempo: aumente a Latencia de recepcao (ms) da entrada SRT — pelo menos 3–4 RTT até a fonte |
Um erro isolado no gráfico é o normal numa rede. O diagnóstico vem da forma: um pente constante de uma causa, rajadas ao redor das faixas de outage, crescimento com o bitrate parado no mesmo nível.
O que vem a seguir
- Reserva de entradas — como transformar o diagnóstico numa comutação.
- TR 101 290 — contadores de transporte por PID.
- Monitoramento — para onde esses contadores vão e como alertar sobre eles.