Redundancia
La autonomía del streamer permite continuar la emisión y la grabación del archivo cuando central falla. La redundancia mantiene disponible la gestión mientras se recupera la máquina afectada.
Esta página describe los componentes de una instalación redundante, cuántas instancias de cada uno ejecutar y qué cambia con una segunda instancia. Para configurarla, consulte Un grupo de central en servidores separados. Sobre el almacenamiento del estado y las garantías, consulte Componentes y fiabilidad.
Qué se hace redundante y qué no
Solo necesita redundancia el plano de control. El procesamiento y la entrega de medios ya son independientes: el streamer recibe la fuente, transcodifica, graba el archivo y entrega el stream. La reproducción desde la dirección pública del streamer no requiere pasar los medios por central.
La regla para una instalación redundante es: central y los streamers funcionan en máquinas separadas. Un streamer local dentro del proceso de central no sirve para esta instalación: sus streams se detienen junto con central.
El mandato: qué instancia hace el trabajo
Varias instancias de central que usan una misma base forman un grupo. Algunas tareas pueden ejecutarse en todas a la vez; otras no: dos layouters podrían cambiar simultáneamente la colocación de los mismos streams.
Ese trabajo lo hace una sola instancia del grupo — la que ha tomado el mandato correspondiente. Tres propiedades del mandato determinan todo el comportamiento del grupo ante un fallo.
- PostgreSQL concede los mandatos, no la configuración. La configuración solo contiene un rol reclamado: «esta máquina está preparada para hacer este trabajo». Active el componente en varias instancias para que otra pueda continuarlo.
- El mandato se libera al finalizar la conexión con la base. Lo mantiene una conexión dedicada: al terminar la sesión, otra instancia obtiene el mandato liberado. No se necesitan tiempos de espera, gestión de ejecutores bloqueados ni confirmación manual.
- Cada concesión tiene un número: la época. Aumenta al cambiar el titular y se comprueba en cada escritura. Si una instancia sigue trabajando tras perder el mandato, sus escrituras se rechazan para impedir que modifique la colocación con resultados obsoletos.
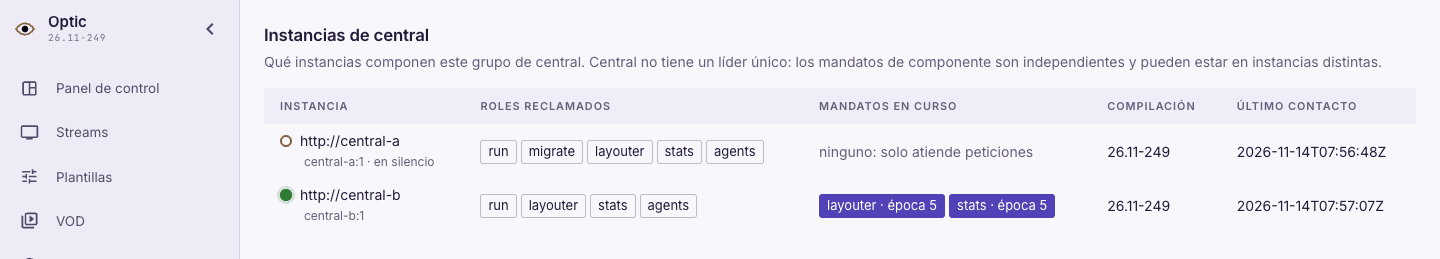
Los mandatos son independientes. Central no tiene un líder único: distintas instancias pueden gestionar la colocación y las estadísticas; es un estado normal.
Quién tiene qué se ve en la consola: Clúster → Central.
Componentes y su cantidad
Central no es un proceso con un rol, sino varios trabajos distintos, y se hacen redundantes de maneras distintas.
| Componente | Cuántos ejecutores | Qué aporta la segunda instancia |
|---|---|---|
| PostgreSQL | Un clúster | Lo hace redundante la propia base de datos, no Optic |
| Manejadores de peticiones | Todas las instancias | La gestión sobrevive a la pérdida de una máquina |
| Conexiones de agentes | Todas las instancias con el componente agents |
El agente se reconecta a un central disponible con la misma URL |
| Estado actual | El titular del mandato stats |
Un titular de recambio; las estadísticas se recopilan de nuevo |
| Layouter | El titular del mandato layouter |
Un ejecutor de recambio sin intervención del operador |
| Migraciones del esquema | Exactamente una instancia | Nada: dos migradores son una carrera, ver más abajo |
| Recolección de sesiones | Un ejecutor por streamer | Los streamers de la instancia caída pasan a una disponible |
| Trabajos periódicos | En todas | Nada: de todos modos lo hace una sola |
| Punto de entrada del operador | Una dirección | — |
| Streamers | Los que requiera la emisión | Su redundancia viene de la colocación, no de aquí |
A continuación, qué hace cada uno y por qué la cantidad es esa.
Manejadores de peticiones
Es lo que el operador y el clúster ven como central: la consola, el API de gestión, el frontal del reproductor, la exportación de métricas y la recepción de la sincronización de los streamers. Un manejador no guarda estado propio — todo está en PostgreSQL —, así que puede haber tantas instancias como se quiera, y a la petición del operador responde cualquiera.
Los streamers usan una lista de direcciones en lugar de un balanceador: cada streamer consulta la primera, pasa a la siguiente tras una petición fallida y vuelve a la primera cuando responde de nuevo. La lista inicial se configura en el streamer; las demás direcciones llegan de central. Cada respuesta de sincronización incluye la composición del grupo, por lo que añadir una tercera instancia no requiere cambios en los streamers — consulte El streamer conoce el grupo por sí mismo.
La segunda instancia aporta dos cosas:
- La gestión sobrevive a la pérdida de una máquina. El operador y los streamers se mudan a una instancia disponible.
- Actualización sin ventana de parada. Las instancias se actualizan por turnos.
Conexiones de agentes
Cada central con el componente agents acepta conexiones endpoint y las gestiona en su propio proceso. El agente tiene una URL; su nombre DNS resuelve a varias instancias de central. Si falla la conexión o el protocolo endpoint, el agente prueba otra IP sin cambiar la URL. Una conexión que funciona permanece en la instancia que la aceptó.
Puede enviar un comando al agente a través de cualquier central: la petición llega a la instancia que tiene su conexión. El túnel de medios streampoint conecta al agente con el streamer asignado. La configuración inicial de endpoint y streampoint se describe en la recepción de vídeo mediante agentes.
Para configurar las direcciones y comprobar la conmutación, consulte el grupo de central.
Estado actual
Central no lee de la base el estado actual que muestra la consola: qué streams están activos y cuántas conexiones de reproducción hay. La base guarda lo que debe ser (ajustes, colocación) y lo que ya ocurrió (sesiones cerradas, registros); el estado actual se mantiene en memoria.
El estado actual es común al grupo y lo mantiene el titular del mandato stats. Las demás instancias lo consultan por la red mediante su dirección anunciada. Por eso todos los streamers son visibles desde cualquier dirección del grupo, aunque informen a distintas instancias.
Al cambiar el titular, las estadísticas se recopilan de nuevo, no se transfieren, a partir de las siguientes sincronizaciones, en segundos. Durante ese intervalo, las cifras de la consola están incompletas: un stream puede estar emitiendo sin aparecer aún en la lista de activos.
No se pierden el archivo, los registros de sesiones ni los ajustes: solo están incompletos los datos del estado actual. Durante el primer medio minuto tras el cambio de titular, las cifras no representan todo el estado del clúster; los avisos de «streams ausentes» se deben a la recuperación de las estadísticas.
Layouter
El layouter decide qué stream funciona en cada máquina. Dos layouters sobre una misma base podrían tomar decisiones y escribir en el diario de colocación simultáneamente, trasladando streams entre máquinas sin motivo.
El titular del mandato layouter ejecuta las pasadas y cada escritura se comprueba con su época. Todas las instancias deben reclamar layouter: si solo lo hace una, el grupo se queda sin colocación cuando falla esa máquina.
Una instancia que no tiene el mandato está completa en todo lo demás: sirve la consola, el API y la sincronización de los streamers. No hay que activar nada durante una avería — el mandato se muda solo.
Migraciones del esquema
El único trabajo que ningún mandato vigila es aplicar las migraciones al arrancar. Dos procesos que arranquen a la vez las lanzarán a la carrera, así que el rol migrate lo declara exactamente una instancia y las demás arrancan después de ella.
Un objeto central.components vacío conserva los valores de las capas anteriores. Si ninguna capa define migrate, está activo por defecto. Una segunda instancia iniciada con una copia de la configuración de la primera será un segundo migrador.
Recolección de sesiones de los streamers
Quién vio qué — las sesiones — central no lo recibe de forma pasiva: las obtiene de los streamers, por un canal continuo hacia cada streamer.
El trabajo se divide por streamer: un ejecutor recibe sus datos en cada momento y distintos ejecutores pueden atender a distintos streamers. Si falla una instancia, otra recibe los datos de sus streamers; el registro de sesiones se conserva.
Un tiempo caído tampoco pierde registros: el streamer guarda su registro de sesiones varios días, y la recolección continúa desde donde se interrumpió. Una hora caído significa que los registros llegarán más tarde, no que no vayan a llegar.
Trabajos periódicos
El resto de las tareas de fondo se ejecuta por horario: limpieza de registros según su retención, control de los almacenamientos VOD (desactivar los de máquinas ausentes y caducar las subidas inacabadas) y retirada del estado de los streamers que dejaron de informar.
Estas tareas se ejecutan en todas las instancias: repetir la limpieza y el control de almacenamientos no cambia el resultado.
No hay que repartir estos trabajos entre instancias a mano, ni desactivarlos en ninguna.
PostgreSQL
La base guarda la configuración y los registros del grupo. Optic no proporciona su redundancia. Todas las instancias necesitan un clúster lógico accesible por una misma dirección; su tolerancia a fallos corresponde a la propia base, mediante una réplica con conmutación o una instancia gestionada por el proveedor.
Dos servidores de base independientes no son redundancia sino dos instalaciones distintas: se les separarán tanto la colocación como el registro de streamers.
Los backups siguen haciendo falta: la reserva protege de la pérdida de una máquina, no de un borrado por error — ver Backup y restauración.
Punto de entrada del operador
El operador necesita una sola dirección que encuentre por sí misma una instancia disponible: un nombre DNS con conmutación o un balanceador delante del grupo.
Los streamers no pasan por él — tienen su propia lista de direcciones, y un intermediario de más en el camino de la sincronización solo añade un punto de fallo.
Streamers
La redundancia de los streamers depende de la colocación, no de la cantidad de instancias de gestión: un stream asignado a más de una máquina sobrevive a la pérdida de cualquiera de ellas. Es un tema distinto de la redundancia de central.
Escenarios
Falla una instancia
Todo ocurre solo, sin intervención.
- Los streamers pasan a la siguiente dirección de su lista tras una petición fallida. No hay que reconfigurarlos, y no hay corte en la emisión.
- Los mandatos de la instancia perdida se mudan a una disponible en segundos. La colocación sigue funcionando, los streams nuevos se colocan como siempre.
- Las estadísticas se recopilan de nuevo. Durante medio minuto las cifras de la consola están incompletas mientras se recuperan las estadísticas.
- El operador trabaja con la misma dirección y la misma contraseña. El estado vive en la base de datos, no en la máquina perdida: el registro de streamers, los ajustes y la colocación siguen ahí.
Si falla la instancia con el rol migrate, otra debe asumirlo durante la recuperación para poder aplicar las migraciones en la siguiente actualización.
Vuelve una instancia
Volver no es una operación de emergencia y no exige ventana de parada.
- Los mandatos permanecen con sus titulares. Un titular que funciona continúa trabajando; otro cambio de titular requeriría recopilar las estadísticas de nuevo.
- Los streamers reanudan la sincronización con su dirección preferida en un plazo de cinco minutos, mediante una petición normal. El orden de las direcciones es la preferencia del operador y se restablece automáticamente.
El grupo funciona en cualquier disposición de los mandatos, así que no hace falta devolverlo a la original.
Actualización planificada
Las instancias se actualizan por turnos, y es el mismo escenario, solo que controlado: mientras se actualiza una, los streamers trabajan con la otra. Los mandatos se mudan dos veces en el proceso — una por reinicio — y las dos veces solos.
Pérdida de la base de datos
La gestión se detiene por completo: puede haber tantas instancias como se quiera, pero el estado entre todas es uno. Mientras la base no esté disponible, la consola y el API no sirven peticiones, y los streams nuevos ni se crean ni se colocan. Durante ese tiempo nadie tiene mandato alguno — es la base quien los emite.
La emisión continúa: los streamers funcionan de forma autónoma, emiten, graban y entregan vídeo sin consultar a central. Por tanto, la pérdida de la base interrumpe la gestión, no la emisión.
La recuperación corre a cargo de la propia base (conmutación a una réplica) o de un backup; ver Backup y restauración.