Un grupo de central en servidores separados
Redundancia explica los componentes de una instalación redundante y qué cambia con una segunda instancia. Esta página describe los ajustes de cada instancia, las direcciones del grupo en los streamers y las comprobaciones de redundancia.
Esta guía configura una instalación existente con instancias separadas de central y streamers conectados. No incluye la instalación del producto, el arranque de los procesos ni la unión de streamers.
Qué se despliega exactamente
Una instalación con reserva tiene cuatro partes, y solo una de ellas es Optic:
- Un clúster PostgreSQL, accesible por todas las instancias en una misma dirección. Es el único almacén de estado y la única parte cuya tolerancia a fallos Optic no asume.
- Dos o más instancias de central — máquinas separadas con la misma configuración, que se diferencian en sus roles y en su dirección anunciada.
- Streamers — máquinas separadas a las que se da no la dirección de una instancia, sino la lista de direcciones del grupo.
- Un punto de entrada del operador — una sola dirección con una instancia disponible detrás: un nombre DNS con conmutación o un balanceador.
La regla para esta instalación es: central y los streamers funcionan en máquinas separadas. Un streamer local dentro del proceso de central no sirve: sus streams se detienen junto con central.
Cuántos de cada uno
| Parte | Cuántos | Nota |
|---|---|---|
| PostgreSQL | Un clúster lógico | Dos servidores de base independientes son dos instalaciones distintas, no una reserva |
| Instancias de central | Dos o más | Una tercera se suma con la misma configuración; las existentes no hay que reescribirlas |
| Streamers | Los que requiera la emisión | Su redundancia viene de la colocación, no de aquí |
| Punto de entrada del operador | Una dirección | Los streamers no pasan por él |
La configuración de una instancia de central
Las instancias de un grupo se diferencian en exactamente dos líneas: la dirección anunciada y el conjunto de roles. Todo lo demás es idéntico, incluida la cadena de conexión a la base de datos.
La primera instancia:
listeners:
  http:
    - port: 80

central:
  database_url: postgres://optic:contraseña@db.example.com:5432/optic
  admin_keys:
    - clave-de-gestion
  components: {run: true, migrate: true, layouter: true, stats: true, agents: true}
  advertise_url: http://central-a.example.com

optic: {}

api_auth:
  login: admin
  password: contraseña-del-operador
La segunda es la misma, sin el rol migrate y con su propia dirección:
central:
  database_url: postgres://optic:contraseña@db.example.com:5432/optic
  admin_keys:
    - clave-de-gestion
  components: {run: true, migrate: false, layouter: true, stats: true, agents: true}
  advertise_url: http://central-b.example.com
Estos ajustes van en el /etc/optic/optic.yaml de cada máquina.
Los roles son declaraciones, no asignaciones
Un rol en la configuración significa «esta máquina está lista para hacer este trabajo», no «esta máquina lo hace». Qué instancia hace realmente el trabajo lo decide PostgreSQL y no la configuración — por eso layouter y stats los declaran las dos, y eso no es un error ni un arranque doble.
run— atender peticiones: la consola, la API de gestión, la sincronización de streamers y las métricas. Necesario en cada instancia.migrate— aplicar las migraciones del esquema al arrancar.layouter— ejecutar las pasadas de colocación.stats— mantener las estadísticas actuales de todo el clúster.agents— aceptar las conexiones de control endpoint de los agentes.
El único rol que no se puede dejar en todas es migrate. No está protegido por un mandato: dos procesos que arranquen a la vez lanzarán las migraciones a la carrera. Por eso el esquema lo aplica una instancia y las demás arrancan después de ella.
central.components se combina campo por campo. Un campo omitido hereda el valor de la capa anterior; true lo activa y false lo desactiva. Un objeto vacío conserva los valores anteriores. El paquete optic activa agents por defecto. Los demás componentes conservan sus valores o los ajustes del operador. Ejemplo:
central:
  components:
    run: true
    migrate: true
    layouter: true
    stats: true
    agents: true
En la segunda instancia, establezca explícitamente central.components.migrate: false. Un archivo drop-in puede cambiar un solo campo sin repetir los demás. Reinicie el proceso para aplicar el cambio.
El array antiguo central.roles ya no se admite, tampoco junto con components. Antes de actualizar, sustitúyalo en todos los archivos: use true para los roles de la lista antigua no vacía y false para los demás para conservar el conjunto exacto. Elimine una lista antigua vacía para mantener los valores predeterminados. El campo antiguo en el archivo principal impide el arranque; en un drop-in genera una advertencia y se omite ese archivo.
La dirección anunciada
advertise_url es la dirección que usan las demás instancias para acceder a esta máquina. Una instancia mantiene las estadísticas actuales y las demás las consultan por la red: el titular publica su dirección para que puedan usarla.
La dirección de un balanceador no sirve aquí — llevaría al vecino de vuelta a sí mismo. La dirección debe ser la de una máquina concreta.
Defina advertise_url en cada instancia del grupo. Sin él, las demás instancias no pueden consultar sus estadísticas ni enviarle comandos para agentes. La consola indica la ausencia de dirección; consulte la comprobación del grupo.
Quién hace qué: los mandatos
El trabajo que no debe ejecutarse simultáneamente lo realiza una instancia: la titular del mandato. El mandato se mantiene en PostgreSQL mediante una conexión dedicada. Al terminar la conexión, se libera sin gestionar ejecutores bloqueados mediante tiempos de espera.
Los mandatos son varios y son independientes. Central no tiene un líder único: layouter y stats pueden acabar en máquinas distintas, y eso es un estado normal, no un desequilibrio.
Cada concesión tiene un número: la época. Aumenta al cambiar el titular y se comprueba en cada escritura. Si una instancia sigue trabajando tras perder el mandato, sus escrituras se rechazan para impedir cambios de colocación con resultados obsoletos. Por ello, el cambio de titular es seguro y no necesita confirmación manual.
El cambio de titular tarda segundos: el tiempo que necesita PostgreSQL para detectar el fin de la sesión y otra instancia para obtener el mandato liberado.
Una instancia sin mandatos sigue atendiendo la consola, la API y la sincronización de streamers. Los mandatos solo afectan a las tareas de fondo.
La configuración de un streamer
El streamer se dirige al grupo, no a un proceso, así que en su configuración va una lista de direcciones:
managed_by:
  name: streamer-01
  url:
    - http://central-a.example.com
    - http://central-b.example.com
  join_token: token-de-union
El orden de la lista es la preferencia del operador. El streamer va a la primera dirección mientras esta responda, pasa a la siguiente tras una petición fallida y una vez cada cinco minutos vuelve a probar la primera: en cuanto revive, la máquina regresa a ella. La prueba es una petición de sincronización normal, no hay una comprobación de disponibilidad aparte: una dirección sirve cuando la sincronización funciona por ella.
La misma lista la acepta la variable de entorno CENTRAL_URL — direcciones separadas por comas.
El streamer aprende el grupo por sí mismo
La configuración del streamer no es la única fuente de direcciones. Cada respuesta a la sincronización lleva la composición del grupo: las direcciones de las instancias disponibles que atienden streamers. El streamer las añade a las direcciones de su configuración — estas se quedan delante, en el orden dado — y guarda lo aprendido en disco junto al resto del estado de la máquina, así que sobrevive a un reinicio y se usa ya desde el registro.
Consecuencias para la operación:
- Puede añadir una instancia sin cambiar las configuraciones de los streamers. Una instancia con la misma base y un
advertise_urlaparece en la composición del grupo en segundos; cada streamer la conoce en su siguiente sincronización. - Un streamer instalado con una dirección recibe la de reserva en su primera respuesta. Los streamers existentes se incorporan al grupo sin cambiar sus configuraciones.
- Una instancia que deja de informar al grupo se retira del anuncio tras veinte segundos, y los streamers la eliminan de las direcciones aprendidas. Los anuncios nunca cambian las direcciones configuradas: no pueden añadirlas ni quitarlas.
Las máquinas que aún no se han sincronizado con central siguen necesitando una segunda dirección configurada. Antes de la primera respuesta, un streamer solo conoce las direcciones configuradas del grupo. Central usa la sincronización como única señal de que el streamer está disponible. Si pierde su única dirección antes de la primera sincronización, se marca como desconectado tras un minuto y medio; el layouter traslada entonces sus streams desde una máquina que sigue funcionando.
Configure la primera instancia como dirección preferida en una parte de los streamers y la segunda en el resto. Así se distribuyen las peticiones de sincronización durante el funcionamiento normal. Si falla una instancia, solo sus streamers pasan a la otra dirección y regresan cuando vuelve a estar disponible.
El punto de entrada del operador
El operador necesita una sola dirección que encuentre por sí misma una instancia disponible: un nombre DNS con conmutación o un balanceador delante del grupo. Un manejador de peticiones no guarda estado propio, así que cualquier instancia puede responder a la petición de un operador.
Los streamers no deben pasar por ese punto de entrada: tienen su propia lista de direcciones, y un intermediario de más en el camino de la sincronización solo añade un punto de fallo.
Qué comprobar tras el despliegue
Abra Clúster → Central en la consola.
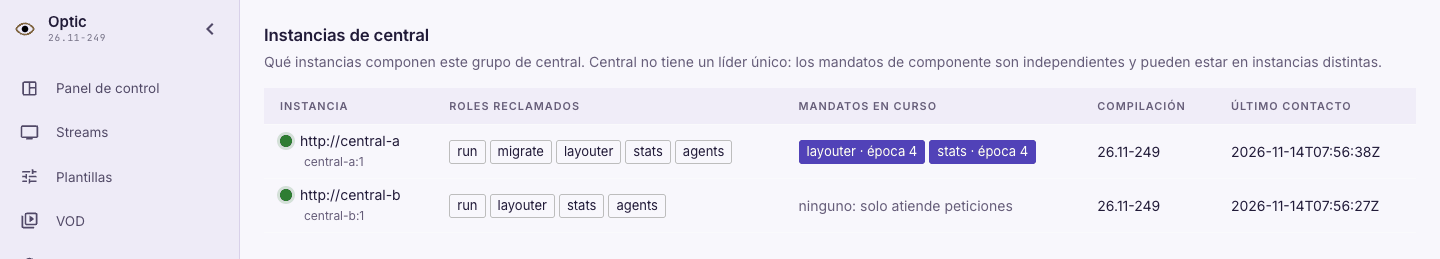
- La tabla tiene una fila por instancia. La fila aparece en segundos tras el arranque. Si no aparece, la instancia no ha conectado con la base.
- La columna Instancia muestra la dirección de cada central. La marca «sin anunciar» significa que las demás instancias no pueden acceder a ella: falta
advertise_url. - La columna Roles reclamados muestra los roles declarados. Compruebe que exactamente una instancia declara
migrate. - Al menos una instancia tiene datos en Mandatos en curso. Si todas están vacías, ninguna ha declarado
layouterostats: el grupo no tiene colocación ni estadísticas actuales. - La columna Compilación es igual en todas las filas. Las distintas versiones en un grupo solo son normales durante una actualización.
- La sección Streamers muestra todos los streamers desde cualquier instancia. Si distintas direcciones muestran listas diferentes, las instancias no reciben estadísticas comunes: revise
advertise_url. - Aparece un archivo
group.jsonen el directorio de estado del streamer (/var/lib/opticen una máquina con paquete), con direcciones de instancias que no figuran en su configuración. Si falta, el streamer aún no ha recibido una respuesta o las demás instancias no tienenadvertise_url.
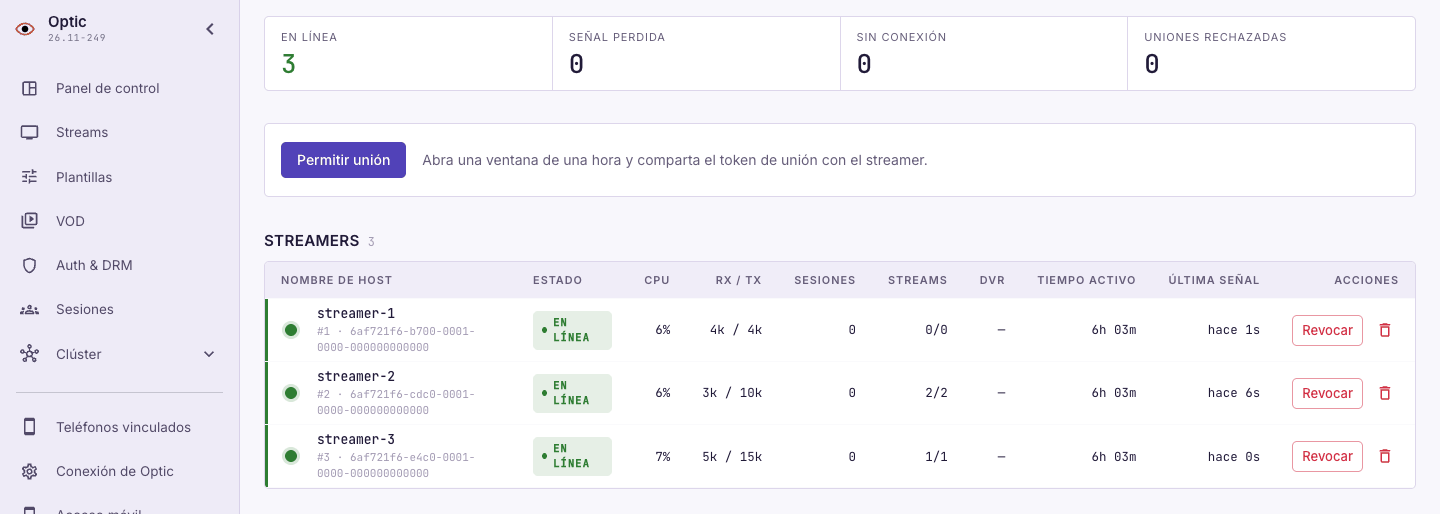
Pruebe la conmutación en una instalación de prueba separada: detenga un central y compruebe la disponibilidad del grupo a través de la instancia restante.
Qué no hace este esquema
- No hace redundante la base de datos. La tolerancia a fallos de PostgreSQL es tarea de la propia base: una réplica con conmutación o una instancia gestionada de un proveedor.
- No sustituye a los backups. La reserva protege de la pérdida de una máquina, no de un borrado por error — ver Backup y restauración.
- No afecta a la emisión. Los streams emiten y graban el archivo sin central; solo se hace redundante la gestión, ver Autonomía del streamer.
Redundancia de conexiones de agentes
Active central.components.agents: true en las instancias que aceptan agentes. El paquete optic lo activa por defecto. Cada central debe tener su propio advertise_url, accesible para las demás instancias.
central:
  components:
    agents: true
Para conectar los agentes, configure un nombre DNS con varias IP de instancias con el componente agents activo. Configure en cada una un certificado TLS para ese nombre. Si falla la conexión o el protocolo endpoint, el agente prueba otra IP de la respuesta DNS. Una conexión que funciona permanece en el central que la aceptó. Puede enviar las peticiones de control a cualquier central.
Para configurar la conexión, consulte la recepción de vídeo mediante agentes.
Si ya utiliza su propio balanceador, los agentes también pueden conectarse a través de él. Debe dirigir las conexiones nuevas a instancias disponibles de central, admitir conexiones de larga duración y conservar las respuestas del protocolo. Si el balanceador procesa HTTP, configure el reenvío de HTTP Upgrade.