Redundância
A autonomia do streamer permite continuar a transmissão e a gravação do arquivo durante uma falha do central. A redundância mantém a gestão disponível enquanto a máquina afetada é recuperada.
Esta página descreve os componentes de uma instalação redundante, quantas instâncias de cada um executar e o que muda com uma segunda instância. Para configurá-la, consulte Um grupo do central em servidores separados. Sobre o armazenamento do estado e as garantias, consulte Componentes e confiabilidade.
O que é tornado redundante e o que não
Somente o plano de controle precisa de redundância. O processamento e a entrega de mídia já são independentes: o streamer recebe a fonte, transcodifica, grava o arquivo e entrega o stream. A reprodução pelo endereço público do streamer não exige que a mídia passe pelo central.
A regra para uma instalação redundante é: o central e os streamers funcionam em máquinas separadas. Um streamer local dentro do processo do central não serve para essa instalação: seus streams param junto com o central.
O mandato: qual instância faz o trabalho
Várias instâncias do central que usam o mesmo banco formam um grupo. Algumas tarefas podem ser executadas em todas ao mesmo tempo; outras não: dois layouters poderiam alterar simultaneamente a alocação dos mesmos streams.
Esse trabalho é feito por uma única instância do grupo — a que tomou o mandato correspondente. Três propriedades do mandato determinam todo o comportamento do grupo diante de uma falha.
- O PostgreSQL concede os mandatos, não a configuração. A configuração contém apenas um papel reivindicado: «esta máquina está pronta para fazer este trabalho». Ative o componente em várias instâncias para que outra possa continuá-lo.
- O mandato é liberado quando a conexão com o banco termina. Ele é mantido por uma conexão dedicada: quando a sessão termina, outra instância obtém o mandato liberado. Não são necessários tempos de espera, tratamento de executores bloqueados ou confirmação manual.
- Cada concessão tem um número: a época. Ele aumenta quando o titular muda e é verificado a cada escrita. Se uma instância continuar trabalhando após perder o mandato, suas escritas serão rejeitadas para impedir alterações na alocação com resultados obsoletos.
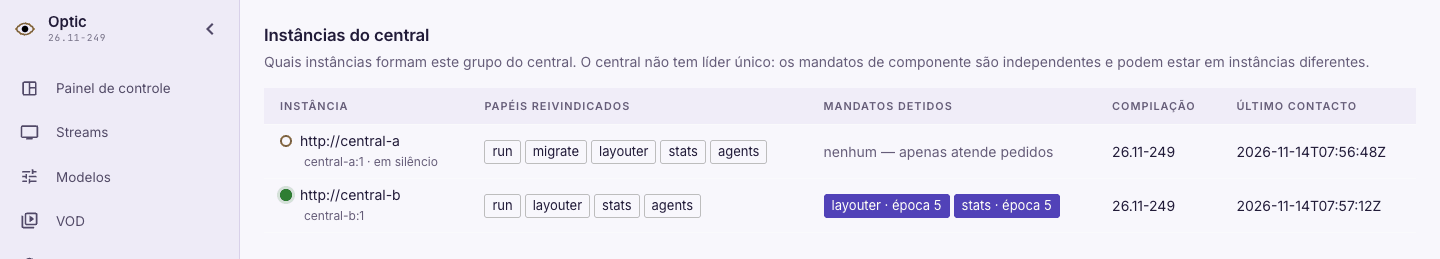
Os mandatos são independentes. O central não tem líder único: instâncias diferentes podem cuidar da alocação e das estatísticas; esse é um estado normal.
Quem tem o quê se vê no console: Cluster → Central.
Componentes e sua quantidade
O central não é um processo com um papel, mas vários trabalhos distintos, e eles são tornados redundantes de maneiras distintas.
| Componente | Quantos executores | O que a segunda instância traz |
|---|---|---|
| PostgreSQL | Um cluster | Tornado redundante pelo próprio banco, não pelo Optic |
| Manipuladores de requisições | Todas as instâncias | A gestão sobrevive à perda de uma máquina |
| Conexões de agentes | Todas as instâncias com o componente agents |
O agente se reconecta a um central disponível pela mesma URL |
| Estado atual | O titular do mandato stats |
Um titular substituto; as estatísticas são coletadas novamente |
| Layouter | O titular do mandato layouter |
Um executor de reposição sem intervenção do operador |
| Migrações do esquema | Exatamente uma instância | Nada: dois migradores são uma corrida, ver abaixo |
| Coleta de sessões | Um executor por streamer | Os streamers da instância caída passam a uma disponível |
| Trabalhos periódicos | Em todas | Nada: de todo modo apenas uma faz o serviço |
| Ponto de entrada do operador | Um endereço | — |
| Streamers | Quantos a transmissão exigir | A redundância deles vem da alocação, não daqui |
A seguir, o que cada um faz e por que a quantidade é essa.
Manipuladores de requisições
É o que o operador e o cluster enxergam como central: o console, a API de gestão, o frontal do reprodutor, a exportação de métricas e a recepção da sincronização dos streamers. Um manipulador não guarda estado próprio — tudo está no PostgreSQL —, então pode haver quantas instâncias se queira, e à requisição do operador responde qualquer uma.
Os streamers usam uma lista de endereços em vez de um balanceador: cada streamer consulta o primeiro, passa para o seguinte após uma requisição malsucedida e retorna ao primeiro quando ele volta a responder. A lista inicial é configurada no streamer; os demais endereços vêm do central. Cada resposta de sincronização inclui a composição do grupo, portanto adicionar uma terceira instância não exige alterações nos streamers — consulte O streamer descobre o grupo por conta própria.
A segunda instância traz duas coisas:
- A gestão sobrevive à perda de uma máquina. O operador e os streamers se mudam para uma instância disponível.
- Atualização sem janela de parada. As instâncias são atualizadas por vez.
Conexões de agentes
Cada central com o componente agents aceita conexões endpoint e as trata em seu próprio processo. O agente tem uma URL; seu nome DNS resolve para várias instâncias do central. Se a conexão ou o protocolo endpoint falhar, o agente tenta outro IP sem mudar a URL. Uma conexão que funciona permanece na instância que a aceitou.
Você pode enviar um comando ao agente por qualquer central: a requisição chega à instância que mantém sua conexão. O túnel de mídia streampoint conecta o agente ao streamer atribuído. A configuração inicial de endpoint e streampoint é descrita na recepção de vídeo por agentes.
Para configurar os endereços e verificar a comutação, consulte o grupo do central.
Estado atual
O central não lê do banco o estado atual mostrado no console: quais streams estão ativos e quantas conexões de reprodução existem. O banco guarda o que deve ser (ajustes, alocação) e o que já aconteceu (sessões fechadas, registros); o estado atual fica na memória.
O estado atual é compartilhado pelo grupo e mantido pelo titular do mandato stats. As demais instâncias o consultam pela rede, no endereço anunciado pelo titular. Por isso todos os streamers ficam visíveis de qualquer endereço do grupo, mesmo quando enviam dados a instâncias diferentes.
Quando o titular muda, as estatísticas são coletadas novamente, não transferidas, a partir das próximas sincronizações, em segundos. Nesse intervalo, os números do console ficam incompletos: um stream pode estar transmitindo sem ainda aparecer na lista de ativos.
O arquivo, os registros de sessões e os ajustes não são perdidos: apenas os dados do estado atual ficam incompletos. No primeiro meio minuto após a troca de titular, os números não representam todo o estado do cluster; avisos de «streams ausentes» correspondem à recuperação das estatísticas.
Layouter
O layouter decide qual stream funciona em cada máquina. Dois layouters sobre o mesmo banco poderiam tomar decisões e escrever no diário de alocação simultaneamente, movendo streams entre máquinas sem motivo.
O titular do mandato layouter executa as passagens, e cada escrita é verificada com sua época. Todas as instâncias devem reivindicar layouter: se apenas uma fizer isso, o grupo ficará sem alocação quando essa máquina falhar.
Uma instância que não tem o mandato está completa em todo o resto: serve o console, a API e a sincronização dos streamers. Não é preciso ativar nada durante uma avaria — o mandato se muda sozinho.
Migrações do esquema
O único trabalho que nenhum mandato vigia é aplicar as migrações na partida. Dois processos que partam ao mesmo tempo vão lançá-las em disputa, então o papel migrate é declarado por exatamente uma instância e as demais partem depois dela.
Um objeto central.components vazio mantém os valores das camadas anteriores. Se nenhuma camada definir migrate, ele fica ativo por padrão. Uma segunda instância iniciada com uma cópia da configuração da primeira será um segundo migrador.
Coleta de sessões dos streamers
Quem assistiu o quê — as sessões — o central não recebe passivamente: ele mesmo as puxa dos streamers, por um canal contínuo até cada streamer.
O trabalho é dividido por streamer: um executor recebe seus dados a cada momento, e executores diferentes podem atender streamers diferentes. Se uma instância falhar, outra recebe os dados de seus streamers; os registros de sessões são preservados.
Um tempo de queda também não perde registros: o streamer guarda seu registro de sessões por vários dias, e a coleta continua de onde parou. Uma hora de queda significa que os registros chegarão mais tarde, não que não vão chegar.
Trabalhos periódicos
As demais tarefas de fundo são executadas por horário: limpeza de registros conforme a retenção, controle dos armazenamentos VOD (desativação dos de máquinas ausentes e expiração dos envios inacabados) e remoção do status dos streamers que deixaram de enviar dados.
Essas tarefas são executadas em todas as instâncias: repetir a limpeza e o controle dos armazenamentos não muda o resultado.
Não é preciso distribuir esses trabalhos entre instâncias à mão, nem desativá-los em nenhuma.
PostgreSQL
O banco guarda a configuração e os registros do grupo. O Optic não fornece sua redundância. Todas as instâncias precisam de um cluster lógico acessível pelo mesmo endereço; sua tolerância a falhas é fornecida pelo próprio banco, por uma réplica com comutação ou uma instância gerenciada pelo provedor.
Dois servidores de banco independentes não são redundância, e sim duas instalações distintas: a alocação e o registro de streamers vão divergir.
Backups continuam necessários: a reserva protege da perda de uma máquina, não de uma exclusão por engano — ver Backup e restauração.
Ponto de entrada do operador
O operador precisa de um único endereço que encontre sozinho uma instância disponível: um nome DNS com comutação ou um balanceador diante do grupo.
Os streamers não passam por ele — eles têm sua própria lista de endereços, e um intermediário a mais no caminho da sincronização só acrescenta um ponto de falha.
Streamers
A redundância dos streamers depende da alocação, não da quantidade de instâncias de gestão: um stream atribuído a mais de uma máquina continua após a perda de qualquer uma delas. Esse assunto é separado da redundância do central.
Cenários
Uma instância falha
Tudo acontece sozinho, sem intervenção.
- Os streamers passam ao endereço seguinte da sua lista após uma requisição malsucedida. Não precisam ser reconfigurados, e não há corte na transmissão.
- Os mandatos da instância perdida se mudam para uma disponível em segundos. A alocação segue funcionando, os streams novos são alocados como sempre.
- As estatísticas são coletadas novamente. Por meio minuto, os números do console ficam incompletos enquanto as estatísticas são recuperadas.
- O operador trabalha pelo mesmo endereço e com a mesma senha. O estado vive no banco, não na máquina perdida: o registro de streamers, os ajustes e a alocação continuam lá.
Se a instância com o papel migrate falhar, outra deverá assumi-lo durante a recuperação para aplicar as migrações na próxima atualização.
Uma instância volta
Voltar não é uma operação de emergência e não exige janela de parada.
- Os mandatos permanecem com seus titulares. Um titular que funciona continua trabalhando; outra troca exigiria coletar as estatísticas novamente.
- Os streamers retomam a sincronização com o endereço preferido em até cinco minutos, por uma requisição normal. A ordem dos endereços é a preferência do operador e é restabelecida automaticamente.
O grupo funciona em qualquer arranjo dos mandatos, então não é preciso devolvê-lo ao original.
Atualização planejada
As instâncias são atualizadas por vez, e é o mesmo cenário, só que controlado: enquanto uma é atualizada, os streamers trabalham com a outra. Os mandatos se mudam duas vezes no processo — uma por reinício — e das duas vezes sozinhos.
Perda do banco de dados
A gestão para por completo: pode haver quantas instâncias se queira, mas o estado entre todas é um só. Enquanto o banco estiver indisponível, o console e a API não servem requisições, e streams novos não são criados nem alocados. Nesse tempo ninguém tem mandato algum — é o banco que os emite.
A transmissão continua: os streamers funcionam de forma autônoma, transmitem, gravam e entregam vídeo sem consultar o central. Assim, a perda do banco interrompe a gestão, não a transmissão.
A recuperação fica a cargo do próprio banco (comutação para uma réplica) ou de um backup; ver Backup e restauração.