Reconocimiento de voz
La estación no inventa teletexto ni subtítulos ocultos: transporta el texto que trajo consigo la imagen. Un canal que no lleva texto alguno no obtiene subtítulos por esa vía, y es justamente ese canal el que suele necesitarlos: una desconexión regional, una emisión corporativa, una fuente ajena sin datos de servicio.
El reconocimiento de voz cubre ese caso: la estación lee el audio del canal grabado y le agrega una pista de subtítulos.
La señal en directo no se toca en absoluto. El reconocimiento trabaja sobre el archivo: lee el audio grabado y escribe allí mismo los subtítulos. De ahí dos consecuencias que conviene conocer de antemano.
- El canal necesita grabación de archivo. Sin ella el reconocimiento no tiene de dónde tomar el audio ni dónde escribir el resultado.
- El retraso es inofensivo. Si el reconocimiento no sigue el ritmo del directo, los subtítulos se retrasan y luego se ponen al día; la salida del canal no se ve afectada.
Cómo activarlo
El reconocimiento vive en la pestaña Procesamiento de la ficha del canal, en la sección Reconocimiento de voz. Lo activa el interruptor Reconocer voz en subtítulos.
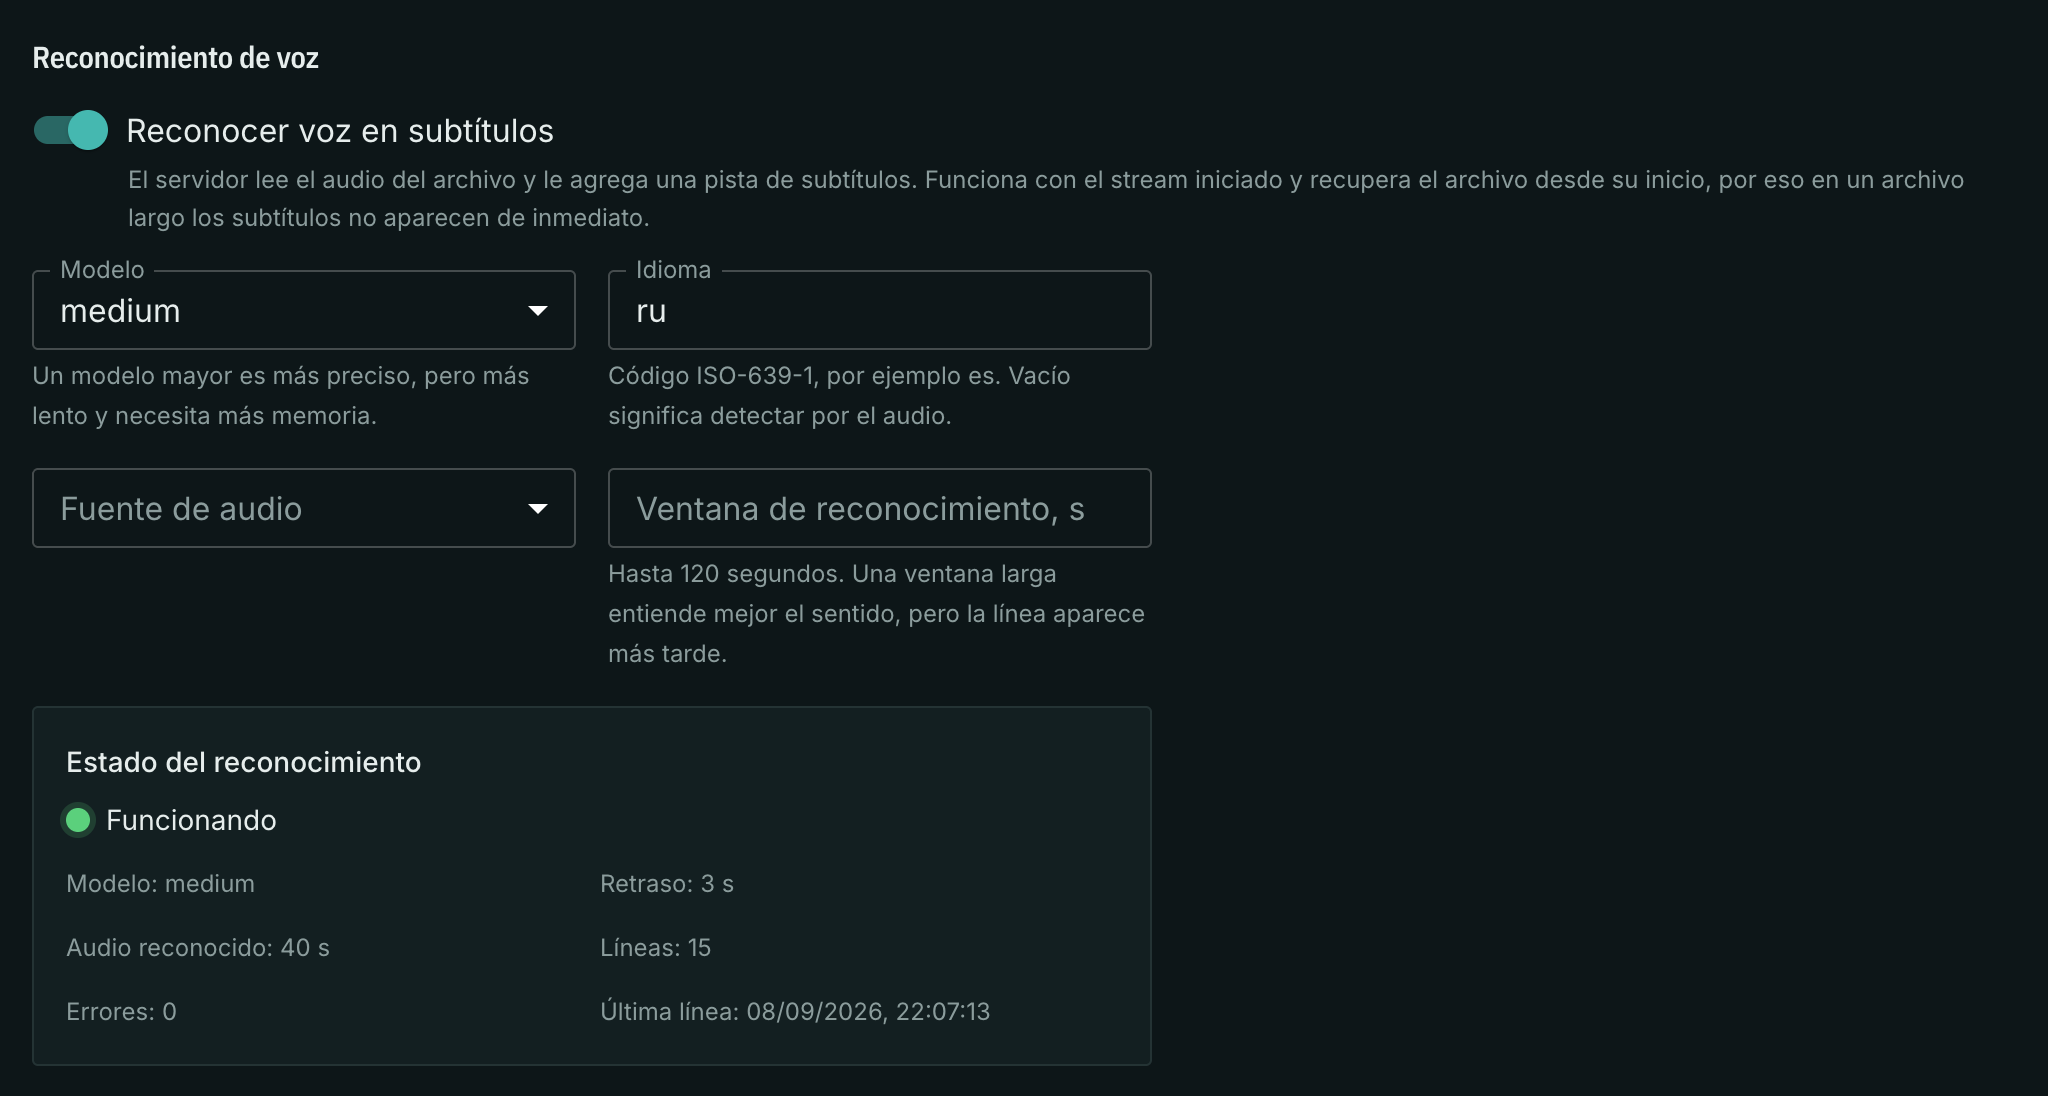
Hay cuatro campos y ninguno es obligatorio: los valores por defecto bastan para activar el reconocimiento con un solo interruptor.
| Campo | Qué define |
|---|---|
| Modelo | El tamaño del reconocedor. Un modelo mayor es más preciso, pero más lento y necesita más memoria. |
| Idioma | Código ISO-639-1, por ejemplo es. Vacío significa detectar por el audio. |
| Fuente de audio | La pista de la emisión que se escucha. La primera por defecto. |
| Ventana de reconocimiento, s | Hasta 120 segundos. Una ventana larga entiende mejor el sentido, pero la línea aparece más tarde. |
Conviene indicar el idioma cuando se conoce. La detección decide con los primeros segundos de audio y se equivoca en un canal que empieza con una cortinilla musical, y un idioma equivocado estropea toda la pista, no una sola línea.
La fuente de audio es asunto cotidiano en una cabecera: el canal lleva varias pistas de idioma y el reconocimiento escucha exactamente una. Si la pista elegida no está al aire, el estado lo dice: «La pista de audio elegida no está al aire».
Sin grabación no arranca
Si se activa el reconocimiento en un canal sin grabación, el panel responde de inmediato, sin esperar a guardar:
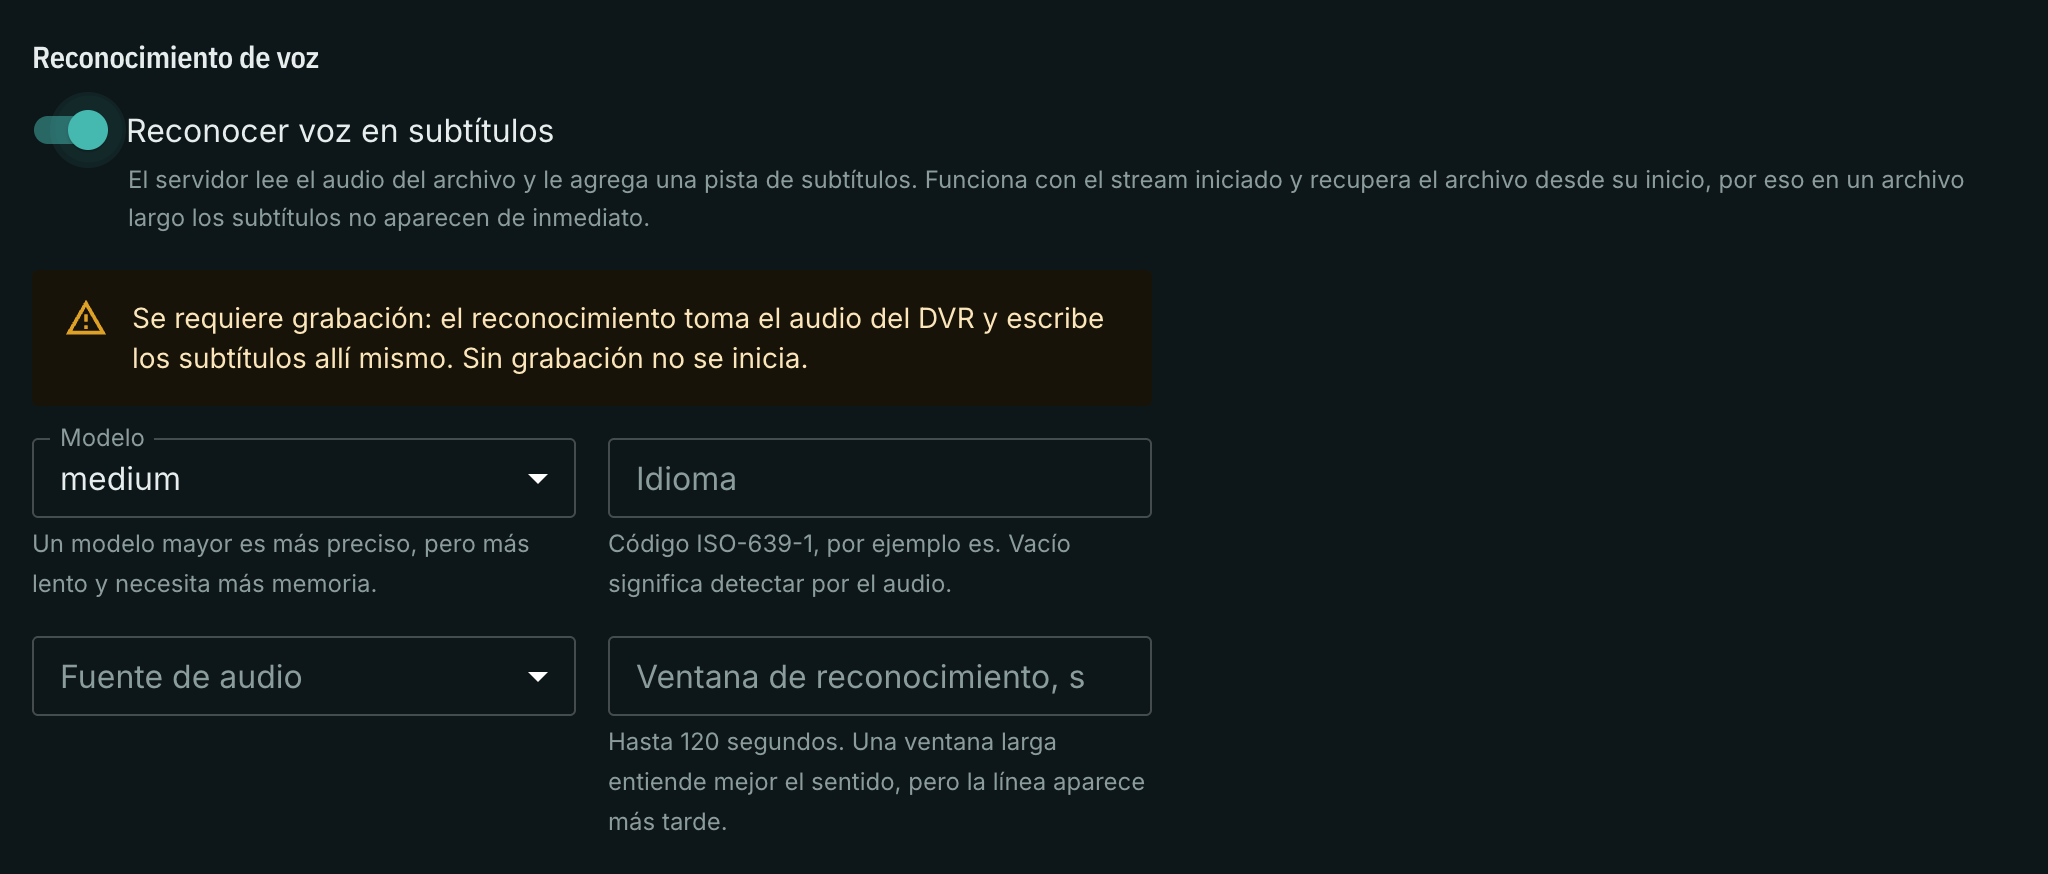
Esto no impide guardar el ajuste: avisa de que no va a funcionar. Active la grabación del canal y el reconocimiento arrancará solo.
Estado del reconocimiento
Bajo el formulario el panel muestra lo que ocurre en realidad. Es el único sitio donde se ve el trabajo vivo del reconocimiento: la ficha del canal toma el estado del nodo donde el canal se graba.
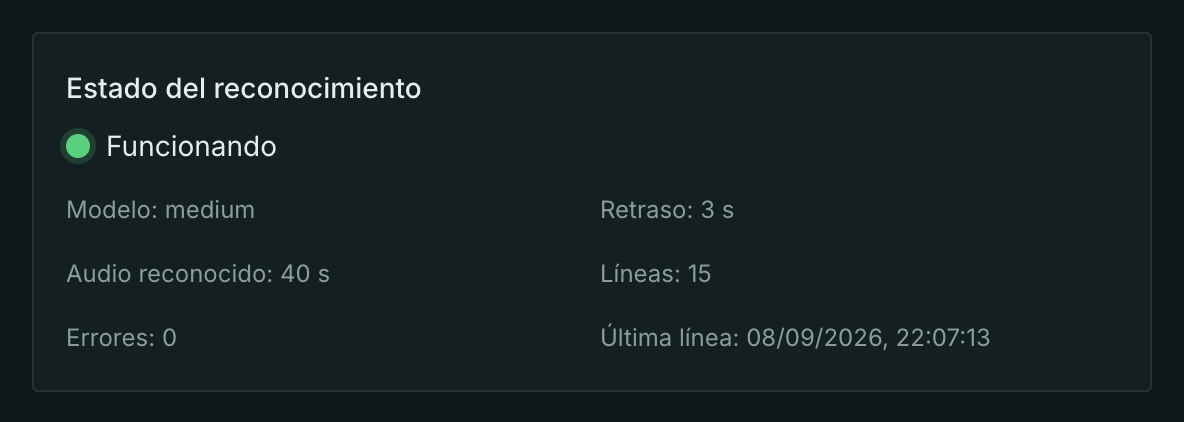
- Funcionando / Detenido — si el reconocimiento está en marcha. «Detenido» siempre viene acompañado del motivo en palabras.
- Retraso — cuánto se queda lo reconocido por detrás del momento actual. En el borde en directo son segundos; en un archivo que el reconocimiento recupera desde el principio son horas, y eso es un modo de trabajo normal, no un fallo.
- Audio reconocido — cuánto audio ha pasado ya por el reconocedor.
- Líneas — cuántas líneas de subtítulos se han escrito.
- Errores — fallos de lectura del archivo y de reconocimiento. Cero aquí es lo habitual.
- Última línea — cuándo escribió algo el reconocimiento por última vez.
El panel nombra directamente los motivos por los que el reconocimiento no arranca:
| Qué dice | Qué hacer |
|---|---|
| El stream no tiene grabación de archivo | Activar la grabación. |
| Falta el archivo del modelo o no se pudo cargar | Poner el archivo del modelo en el servidor (más abajo). |
| La pista de audio elegida no está al aire | Elegir otra fuente de audio o dejar el valor por defecto. |
| El reconocedor no conoce ese idioma | Revisar el código de idioma o vaciar el campo. |
| Esta compilación del servidor no tiene reconocimiento de voz | Contactar con el soporte: el servidor está compilado sin el motor. |
Un reconocimiento que funciona y tiene un error reciente es un aviso, no una avería: un fragmento no leído no detiene el trabajo, el reconocimiento sigue con el siguiente.
El archivo del modelo
El modelo no se entrega con el servidor: uno utilizable pesa más de un gigabyte y cuál hace falta lo decide el dueño de la estación. El servidor lo busca en el directorio de estado del producto — /var/lib/mcaster/whisper-models — y espera allí un archivo ggml-<modelo>.bin, es decir ggml-medium.bin para el modelo medium.
Mientras el archivo no está, el estado del reconocimiento dice honestamente «Falta el archivo del modelo o no se pudo cargar», y el canal sigue funcionando y grabando como si nada.
Un solo archivo sirve a todos los canales de la estación: el modelo se lee en memoria una vez por proceso, por muchos canales que lo pidan.
Qué sale a la salida
Lo reconocido se convierte en una pista de subtítulos normal del canal: aparece en la información de medios y viaja a la copia OTT como WebVTT — justo donde hace falta una pista de texto, porque ningún reproductor OTT decodifica teletexto.
El flujo de transporte no llevará el texto reconocido: una pista de subtítulos no tiene en qué viajar dentro de MPEG-TS, la misma limitación que la extracción de teletexto.
Tiene sentido ver la pista sobre el archivo. En el borde en directo los subtítulos aún no están: aparecen con el mismo retraso que muestra el estado.
Qué sigue
- Subtítulos y teletexto — qué hacer con el texto que el canal ya transporta.
- Grabación y lectura del archivo — sin lo cual el reconocimiento no arranca.
- Copia OTT — adónde va la pista reconocida.