Probar un grupo de central en Docker
Redundancia explica cómo está construido un grupo de central, y Un grupo de central en servidores separados explica cómo desplegarlo. Esta página trata de verlo funcionar con sus propios ojos: en una sola máquina, a partir de contenedores, en diez minutos y sin alquilar un solo servidor.
El banco es desechable. En él se puede — y se debe — hacer lo que no se hace en una instalación en servicio: matar procesos en pleno vuelo y ver qué sale de ello.
Qué hace falta
- Docker con compose — no hay nada más que instalar.
- Una clave de licencia. La necesita cada proceso: los dos central y los tres streamers.
- Los puertos 8081 y 8082 libres en la máquina local.
De qué está hecho el banco
Seis contenedores:
- postgres — una base de datos para todo el grupo.
- central-a y central-b — dos instancias del plano de control sobre esa base, con consolas en los puertos 8081 y 8082.
- streamer-1 y streamer-2 — dos streamers repartidos entre las instancias: el primero va a central-a, el segundo a central-b.
- streamer-3 — un streamer al que se le dio una sola dirección, central-b. De la segunda instancia solo puede enterarse por el propio central.
Repartir los streamers entre instancias no es un adorno, es el sentido del banco. La imagen del «ahora mismo» es una sola para el grupo, y todo el parque debe verse desde cualquiera de las dos direcciones, aunque las máquinas reporten a instancias distintas. El tercer streamer es la situación de cualquier máquina de un parque existente el día en que se añade una segunda instancia a la instalación: nadie va a reescribir la configuración en mil máquinas.
Descargue el docker-compose.yaml en un directorio vacío. Abajo están las partes por las que fue escrito; el resto es fontanería corriente.
La primera instancia declara los cuatro roles, migrate incluido:
central:
  admin_keys:
    - lab-admin-key
  roles: [run, migrate, layouter, stats]
  advertise_url: http://central-a
La segunda es la misma sin migrate: el esquema lo aplica un solo proceso, o dos lanzan las migraciones a la carrera.
central:
  admin_keys:
    - lab-admin-key
  roles: [run, layouter, stats]
  advertise_url: http://central-b
Los roles layouter y stats los declaran las dos, y eso no es un arranque doble: un rol es una declaración, y al ejecutor lo elige un mandato.
A un streamer no se le da la dirección de una instancia sino la lista de direcciones del grupo; el orden es el orden de preferencia:
managed_by:
  name: streamer-1
  url:
    - http://central-a
    - http://central-b
  join_token: ${JOIN_TOKEN}
El segundo streamer tiene la misma lista en orden inverso. Al tercero se le da una sola dirección — la que el laboratorio apagará después:
managed_by:
  name: streamer-3
  url: http://central-b
  join_token: ${JOIN_TOKEN}
Los streamers corren la misma imagen que central: un streamer de un clúster Catena es el mismo binario de Catena, y necesita la misma licencia.
Levantarlo
El banco no se monta con un solo docker compose up: la ventana de unión la abre un central vivo, y el token de unión solo existe después de que arranque.
Primero la base de datos y las dos instancias del plano de control:
export CATENA_VERSION=latest
export LICENSE_KEY='su clave'
docker compose up -d postgres central-a central-b
Espere a que la consola se abra en http://127.0.0.1:8081 y entre como admin con la contraseña pass. En el primer inicio de sesión la consola pide crear una cuenta nominal — créela.
Abra Clúster → Streamers, pulse Permitir unión y copie el token de unión. Levante los streamers con él:
JOIN_TOKEN=jt-... docker compose up -d streamer-1 streamer-2 streamer-3
Las tres máquinas aparecen en la lista de streamers en segundos. Cierre después la ventana de unión — el parque está montado.
Cree unos cuantos streams para que el clúster tenga algo que colocar. La entrada syntetic es el generador incorporado; el banco no necesita ninguna fuente externa:
for i in 1 2 3 4 5 6; do
  curl -s -X PUT -H 'Authorization: Bearer lab-admin-key' \
    -H 'Content-Type: application/json' \
    -d '{"inputs":[{"syntetic":{}}]}' \
    "http://127.0.0.1:8081/central/api-v4/streams/configs/cam$i"
done
El grupo entero
Abra Clúster → Central.
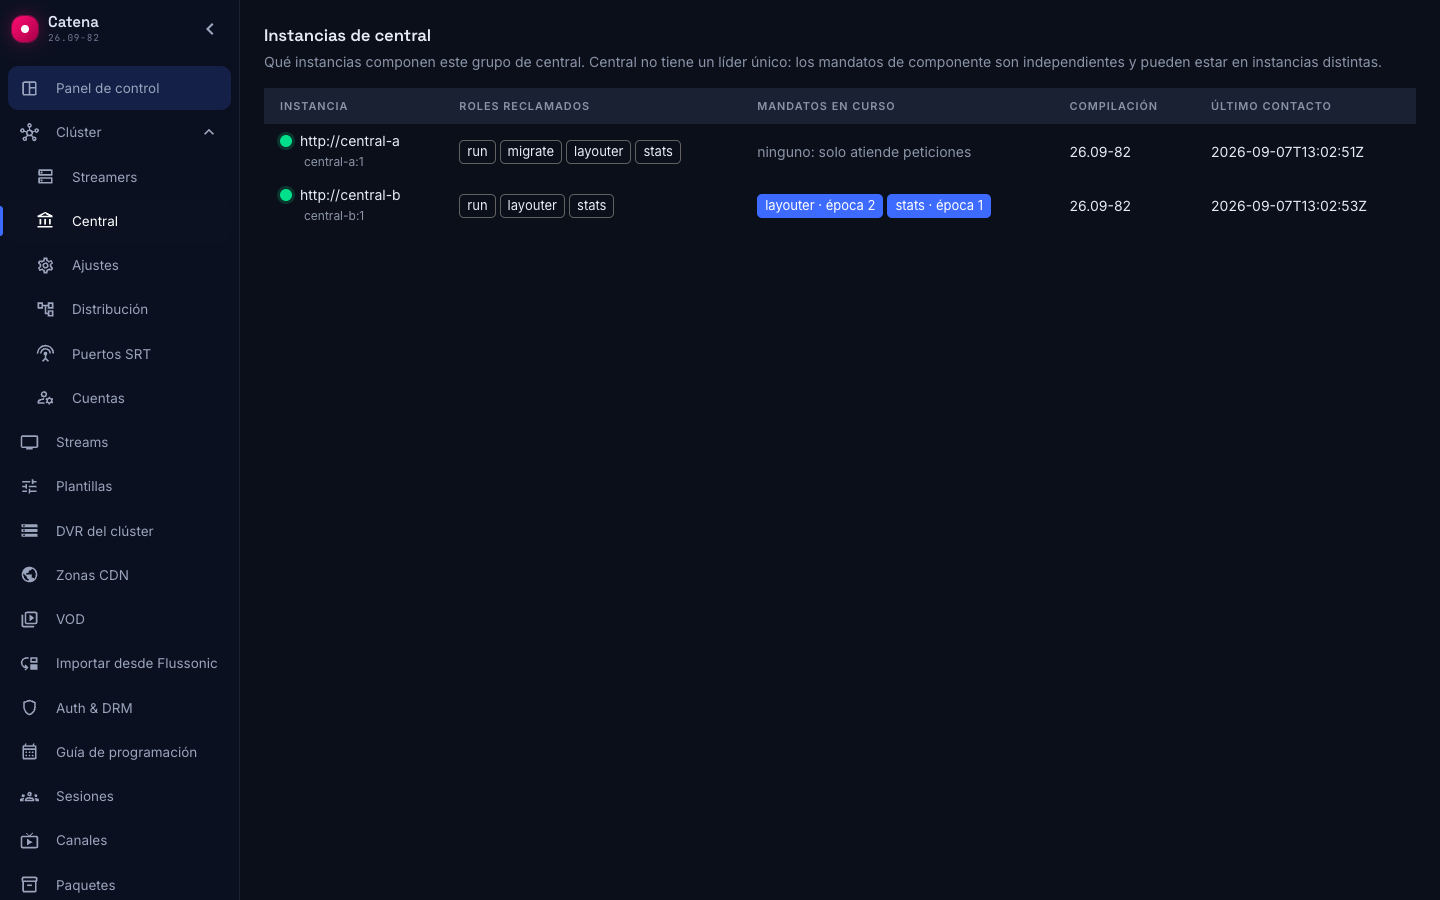
La tabla tiene dos filas — el grupo entero — y cualquier instancia la muestra igual: el registro está en la base de datos común.
- Los roles reclamados son casi iguales en las dos:
migratesolo lo declaracentral-a, todo lo demás lo declaran ambas máquinas. - Los mandatos en curso solo están rellenos en una fila. Esa es la respuesta a «quién manda aquí»: nadie manda, hay titulares de mandatos concretos.
- La segunda fila dice ninguno: solo atiende peticiones. Una instancia así no es una reserva ni está dormida: responde por completo a la consola, al API y a los streamers; simplemente ahora mismo no es ella la que hace el trabajo de fondo.
En su banco los mandatos pueden quedar de otra manera — los dos en una máquina o uno en cada una. Los mandatos son independientes y su disposición depende de quién llegó primero; aquí no hay disposición incorrecta.
El parque se ve desde cualquier dirección
Sin salir de la instancia, abra Clúster → Streamers.
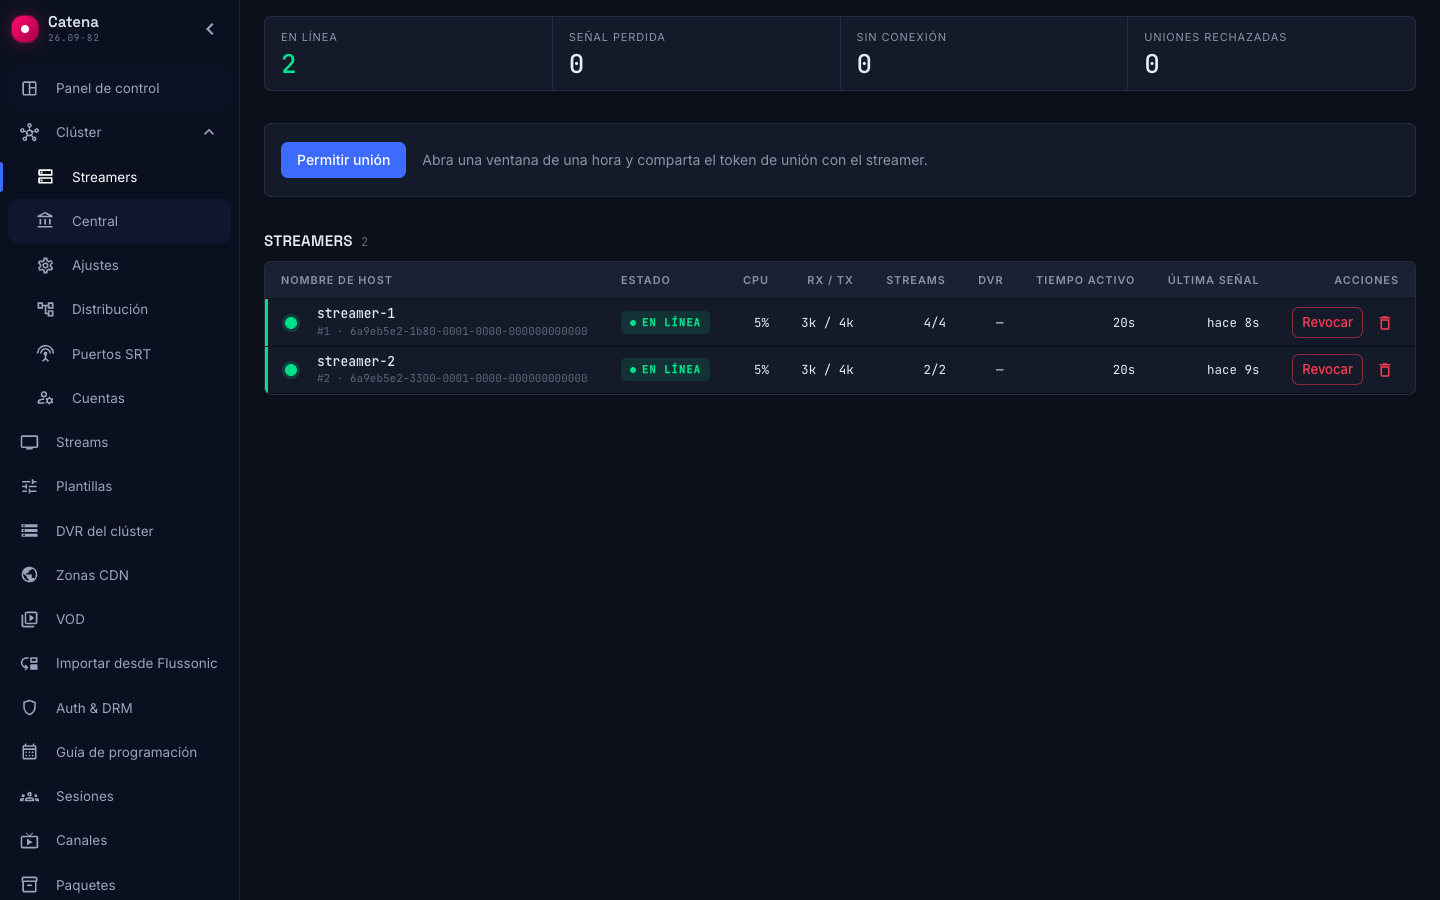
Las tres máquinas están en el aire, aunque a esta instancia solo le reporta una de ellas. Las otras mandan su sincronización al vecino y se ven aquí porque la imagen del «ahora mismo» es una sola para el grupo: una instancia sin el mandato stats llega a ella por la red, justamente por esa dirección anunciada.
Abra la misma página en http://127.0.0.1:8082 y verá lo mismo. Esa es la comprobación para la que los streamers están repartidos entre instancias.
Matamos al titular del mandato
Ahora aquello por lo que el banco es desechable. Mate la instancia que tiene los mandatos — en las capturas de arriba es central-b:
docker compose stop central-b
Vuelva a Clúster → Central en la instancia viva y espere unos segundos.
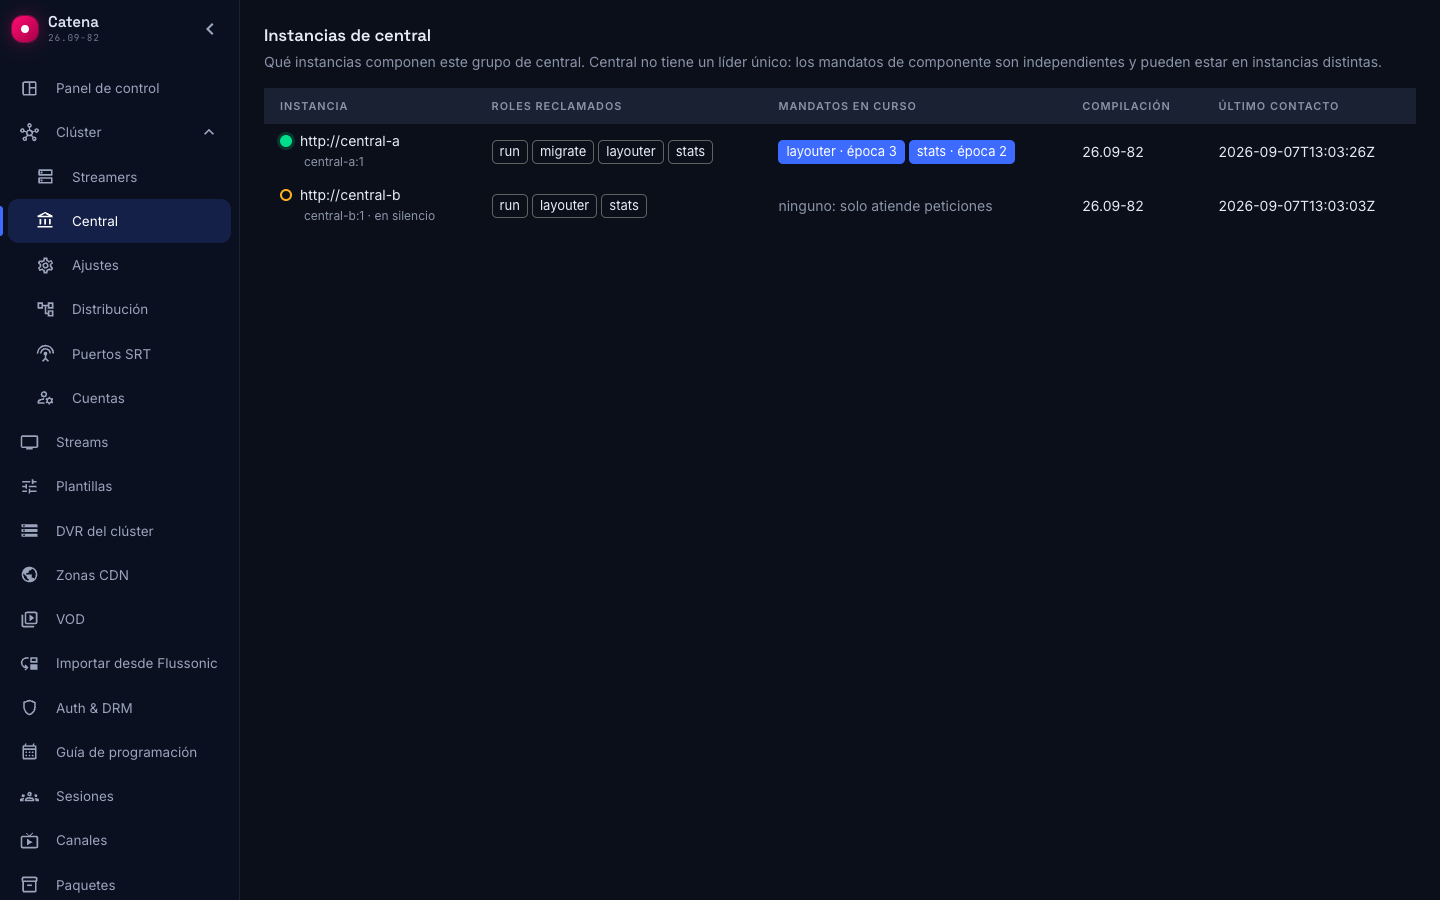
Han cambiado tres cosas:
- La fila de la instancia matada no ha desaparecido, está marcada: «en silencio: lo más probable es que el proceso haya muerto». El grupo recuerda su composición, no solo a los vivos.
- Los mandatos se han mudado a la instancia viva. Nadie los ha entregado: un mandato vive en una conexión propia con PostgreSQL y se libera con la muerte de esa sesión, y el vecino viene a por el liberado por su cuenta.
- El número de época ha crecido. Crece en cada cambio de titular y viaja con cada escritura: una instancia que despierta y ya no es la titular recibe un rechazo en la escritura, en lugar de estropear la colocación a posteriori.
La mudanza tarda segundos. No hay que confirmarla a mano, ni con qué.
El streamer que conocía una sola dirección
Abra Clúster → Streamers — todavía en la instancia viva.
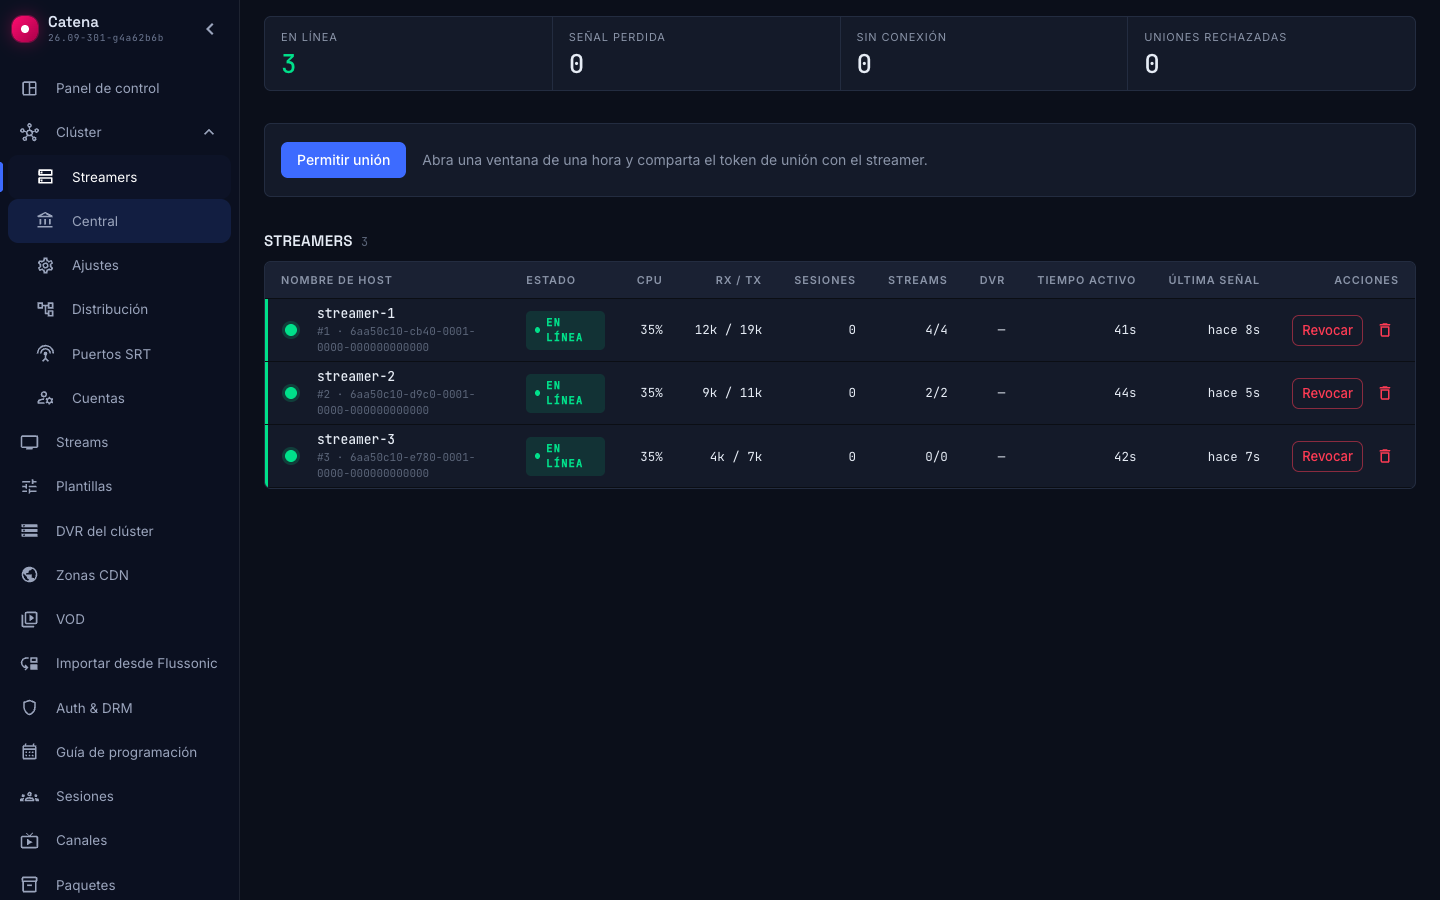
Las tres máquinas están en el aire, y la tercera es aquella cuya configuración nombra solo el central-b que acaba de apagar. No conocía la segunda dirección por su configuración y aun así pasó a ella tras una petición fallida: central ni siquiera llegó a darla por perdida.
La dirección la aprendió del propio central. Cada respuesta a la sincronización lleva la composición del grupo — las direcciones de las instancias vivas que atienden streamers —, y el streamer las añade a las que tiene en su configuración. Lo aprendido se guarda en disco junto al resto del estado de la máquina, por lo que sobrevive a un reinicio:
docker compose cp streamer-3:/var/lib/catena/group.json group.json && cat group.json
{
  "announced": [
    "http://central-a"
  ]
}
En el registro del streamer ese momento lo marca la línea the central group roster changed — en ella van primero las direcciones de la configuración y después las aprendidas. El cambio en sí es la línea switching to the next central address.
Compruebe también el reinicio: docker compose restart streamer-3 con central-b todavía apagado levanta los streams desde la caché sin esperar a la red y, tras una petición fallida a central-b, lleva la máquina a central-a — la dirección se lee del disco, aunque su configuración no sabe nada de una segunda instancia.
Lo que el anuncio no sustituye es la primera respuesta. Un streamer que nunca se ha sincronizado y ha perdido su única dirección no sabe nada del grupo: minuto y medio después figura como offline, y el layouter mueve sus streams a otras máquinas. Por eso las máquinas con las que se levanta un parque reciben las dos direcciones, y el anuncio cubre todo lo demás — añadir instancias a un parque que ya funciona.
El aire no se ha enterado
Abra Streams.
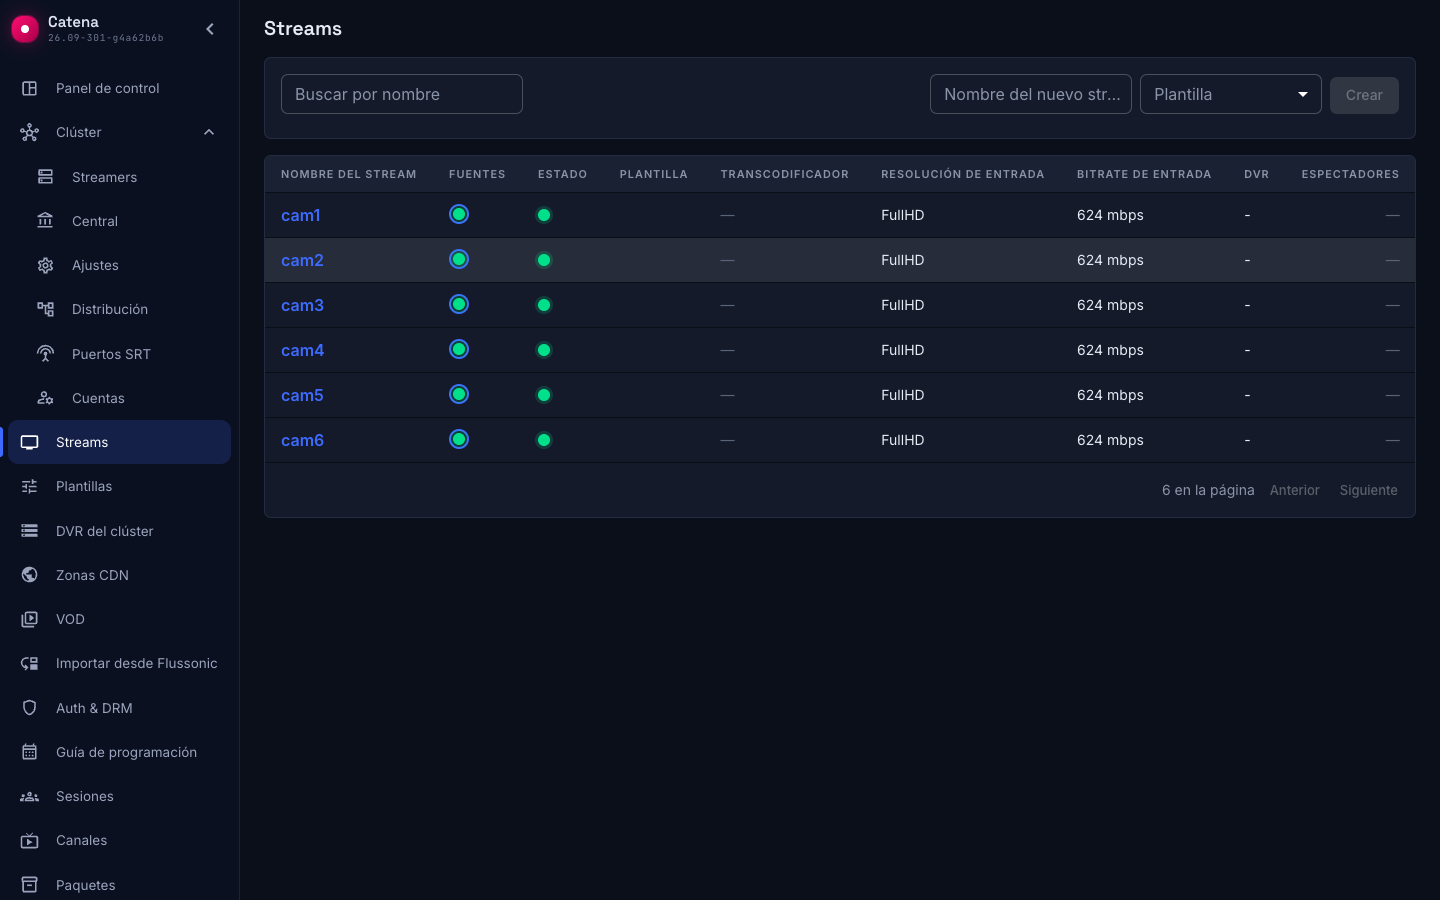
Los seis streams siguen. Los que viven en los streamers que reportaban a la instancia matada no notaron la mudanza: un cambio de dirección de gestión no es un evento para el aire.
Devolvemos la instancia
docker compose start central-b
La fila vuelve a encenderse. Los mandatos no vuelven — y eso es una decisión, no algo por terminar: no hay nada que ganar quitándoselos, el titular está trabajando, y un cambio de titular cuesta una nueva encarnación de la imagen del «ahora mismo».
Los streamers, en cambio, sí vuelven. Una vez cada cinco minutos el streamer prueba la primera dirección de su lista con una petición de sincronización normal: central-b respondió, así que streamer-2 y streamer-3 vuelven a ir a él, porque el orden de la lista es la preferencia del operador, no una pista de partida. Espere cinco minutos y mire el registro:
docker compose logs --since 6m streamer-2 | grep -i 'preferred'
Un regreso con éxito lo marca la línea trying the preferred central address again sin nada detrás; si la dirección siguiera muerta, la seguiría the preferred address is still down, y el streamer se quedaría donde estaba.
Se puede devolver la disposición original de los mandatos con un reinicio — para eso el banco es desechable —, pero en producción no hace falta: el grupo funciona en cualquier disposición.
Retiramos el banco
docker compose down -v
La opción -v retira también los volúmenes: la base de datos, el estado de los streamers, su identidad en el clúster y las direcciones del grupo que aprendieron. Sin ella el siguiente arranque hereda un estado medio ajeno.
Qué no muestra este banco
- Un fallo de la base de datos. Aquí es única y sin réplica: mátela y la gestión se detendrá por completo mientras el aire sigue. Es cierto, pero la redundancia de la base es tarea de la propia base.
- La red. Todos los contenedores están en una misma red de docker, sin pérdidas ni latencia entre ellos.
- La carga. Seis streams sintéticos no dicen nada sobre cómo se comporta el grupo en un parque real.
- El punto de entrada del operador. En el banco hay dos, uno por instancia; en producción hace falta una sola dirección con conmutación.